




Pinned Tweet
🛞صرت أدير جهازي ومشاريعي كلها من الجوال📱
بنيت مشروع بسيط من فترة وسميته (مِقود)
ايه سميته مقود لانه زي مقود السيارة يدير العمل بالكامل من جوالي على اي اداة وحتى لو حسابي منتهي الرصيد في codex اقدر عن طريق الدردشة العادية اعطيه الاوامر وأتابع العمل.
بدأت بفكرة بسيطة وبعدها توسع العمل واضفت مزيد من الافكار والخصائص يعني أكتب طلبي في محادثة، يصل إلى جهازي في البيت. مقود يختار الأداة المناسبة من الأدوات البرمجية الموجودة فيه، ويتابع التنفيذ، ثم يفحص العمل قبل أن يصلني التقرير.
أضفت له خاصية التوزيع أيضاً، بحيث يوزع العمل على المهام أو على النماذج الموجودة في الجهاز بمختلف أنواعها وعلى عدة نماذج.
يعني مثلاً: OpenCode، أو Command code، أو Antigravity، أو Claude code، أو Codex، أو أي أداة موجودة في الجهاز يرتبط بها ويوزع العمل.
وبعد فترة اضفت أداة مع سميتها (ذراع): وهو زي اليد في المتصفح تفتح المواقع، وتضغط، وتعبّئ النماذج، وتختبر الواجهات. وبكذا اقدر اكمل الأعمال على الويب دون أن ألمس الجهاز.
إذا انقطعت الجلسة، بس أقول كمّل، فيكمل من آخر خطوة وبدون ماينسى.
تكتب من جوالك، والجهاز يكمل العمل.
وهذا فيديو تعريفي بالخدمة وللعلم هو اللي سوا الديمو 😆
OpenAI تعلن عن GPT-6.2 Astra وSol.. والتركيز هذه المرة على إنجاز العمل، مو مجرد الإجابة عن الأسئلة!
أعلنت OpenAI عن نموذجين جديدين، وكل واحد مخصص لنوع مختلف من المهام.
GPT-6.2 Astra موجه للأعمال المعقدة. يقدر ينفذ مهام برمجية طويلة، ويتعامل مع المشاريع القائمة، وينشئ عروضًا تقديمية وجداول ومستندات احترافية، بل ويستخدم برامج التصميم والمحاكاة ثلاثية الأبعاد.
أما GPT-6.2 Sol فهو مخصص للعمل اليومي، أسرع وأقل تكلفة، ومع ذلك اقترب من أداء Astra في بعض اختبارات البرمجة بفارق بسيط، وبتكلفة تقارب الخُمس.
اللافت أن Astra تفوق على الإصدار السابق في اختبارات المهام المهنية متعددة الخطوات، مع انخفاض تكلفة التنفيذ إلى أقل من الثلث. كذلك خفضت OpenAI أسعار رموز الإدخال والإخراج له بنسبة 20%.
وفي جانب البرمجة، ركزت الشركة على تحسين جودة الكود، ودقة الاختبارات، وتقليل التعديلات المتكررة، إلى جانب تعزيز اكتشاف الثغرات وإصلاحها.
النموذجان متاحان عبر ChatGPT Work وCodex للفئات المؤهلة، وكذلك عبر API.

Some of you have been asking very politely. Some of you have just been asking.
GPT-6.2 Astra and Sol are now available.
Super efficient and built to perform where it counts—the real world.
openai.com/index/introducing…
55
استمرار مهام الوكيل دون انقطاع عبر تجديد جلسات خوادم MCP في مكانها 🔄
لما يحتاج خادم MCP مثل Slack تسجيل دخول جديد أثناء تنفيذ الوكيل لمهمته، كان المطور يضطر يخرج من نافذة المحادثة ويعيد الربط يدوياً. التحديث الجديد داخل تطبيق GitHub Copilot يتيح للمحادثة نفسها تقديم الموصل المناسب وإعادة ربطه في مكانه مباشرة، لتستأنف المهمة فوراً من حيث توقفت.
القيمة الهندسية تكمن في تحويل تجديد الجلسات المنتهية إلى معالجة ذاتية داخل دورة تنفيذ الوكيل، بدل أن تتحول إلى استثناء تنفيذي يقطع تسلسل العمل.
وفي جانب بيئة التشغيل، أكدت GitHub إزالة Local harness من تطبيق VS Code بحلول فبراير 2027، مع اعتماد Copilot harness كخيار افتراضي لكافة الجلسات الجديدة وتوفير دليل انتقال لسير العمل القائم.
التفاصيل التقنية وروابط الإصدار بالتغريدة التابعة 👇
#GitHubCopilot #AIAgents

1
50
رابط تدوينة GitHub الرسمية لإصدارات Copilot الأسبوعية:
github.blog/changelog/2026-1…
التفاصيل الفنية للإصدار:
1. إتاحة نموذجي Claude Fable 5.2 وGemini 4 Carbon لمشتركي باقات Copilot Pro+ وMax وBusiness وEnterprise.
2. نموذج Fable 5.2 يتطلب الاحتفاظ بالبيانات افتراضياً، وميزته مغلقة افتراضياً للمؤسسات وتحتاج تفعيل يدوي من مسؤولي Business وEnterprise.
3. التحديث يخص تطبيق GitHub Copilot المستقل ومحرر VS Code إصدار 1.146.

24
تغطية ثغرات اللغات غير المدعومة في CodeQL تكتمل بفحص الذكاء الاصطناعي 🛡️
أي مستودع مكتوب بلغات خارج نطاق CodeQL كان يمر تاريخياً بدون نتائج فحص في تبويب الأمان، ويترك المستودع مكشوف أمنياً. أداة AI Scan for repositories تفحص الفرع الافتراضي للمستودع وتغطي هذه اللغات، وتكتشف مشاكل إضافية حتى داخل اللغات التي يحللها CodeQL نفسه.
الجديد لفرق العمل التي تدير مستودعات متعددة هو إمكانية تشغيل الفحص الجماعي لما يصل إلى 20 مستودع في وقت واحد، سواء من إعدادات المؤسسة مباشرة أو من صفحة تنبيهات الأمان العامة للمنظمة، بدل فتح كل مستودع وضبطه بشكل فردي، والميزة حالياً في مرحلة المعاينة العامة.
الأهم معمارياً أن التنبيهات ترصد مباشرة في قائمة code scanning نفسها بجانب تنبيهات CodeQL، فعمليات الفرز وتتبع المعالجة تبقى مجمعة في مسار واحد بدون فتح لوحة أمان منفصلة، والأداة لا تتطلب اشتراك GitHub Copilot.
الروابط والتفاصيل بالتغريدة التابعة 👇
#GitHub #AppSec

1
1
62
إعلان GitHub عن إطلاق الفحص الجماعي لأداة AI Scan:
github.blog/changelog/2026-1…
تفاصيل فنية:
الفحص يشتغل على الفرع الافتراضي للمستودع.
يمكن تشغيله لمستودع فردي من صفحة التنبيهات الخاصة به أو لـ 20 مستودع دفعة واحدة.
متاح على github.com وGitHub Enterprise Cloud مع خيار إقامة البيانات (data residency) ولا يتطلب رخصة Copilot.

23
تقليص نافذة كشف الثغرات إلى النصف يفرض سباقاً حتمياً بين النماذج وفرق الحماية 🔐
سياسة الكشف المنسق عن الثغرات عند Anthropic كانت تقوم على فرضيتين، الأولى أن دورة الترقيع تمشي بسرعة المطور البشري، والثانية أن احتمال وصول طرف ثان لنفس الثغرة خلال المهلة ضعيف جداً. الواقع الهندسي مع نماذج الفحص المتقدمة أسقط الفرضيتين، لأن الثغرة اللي يكتشفها نموذج صار يرصدها نموذج ثان بوقت متزامن.
التحول المباشر يمس مشرفي المشاريع مفتوحة المصدر، مهلة المعالجة قبل النشر للعموم انخفضت إلى 30 يوماً للثغرات الحرجة والعالية، و45 يوماً لبقية الثغرات، بدءاً من بلاغات مطلع عام 2027. وفي حال غياب تجاوب المطور، تصعّد الشركة البلاغ لجهات التنسيق خلال 15 يوماً.
المعادلة واضحة، وتيرة ترقيع الكود ما عاد ينفع تتأخر عن سرعة رصد النماذج لها. لذلك أرفقت الشركة إرشادات مباشرة وحلول ترقيع مؤقتة مع البلاغات، مع إتاحة خدمة فحص دورية مجانية للمشاريع الحساسة بأقوى نماذجها لتقليل الفجوة.
التفاصيل وروابط التحديث بالتغريدة التابعة 👇
#CyberSecurity #OpenSource

1
64
إعلان Anthropic عن تحديث سياسة الكشف المنسق عن الثغرات:
anthropic.com/research/coord…
تفاصيل إضافية من وثيقة السياسة المعلنة:
مهلة 7 أيام للثغرات المستغلة فعلياً مستمرة كما هي دون تغيير.
فترة حظر التفاصيل التقنية بعد توفر الترقيع أصبحت 30 يوماً بدل 45 يوماً.
البلاغات المفتوحة قبل 1 يناير 2027 تحتفظ بالمهل القديمة دون أثر رجعي.
نتائج الفحص الآلي غير المراجعة بشرياً لا تخضع لهذه الجداول.
مشاريع البنية التحتية ذات التوزيع المعقد يُتفق على جدولها بالتنسيق المباشر.

21
استغلال ثغرات الصفر بدون تدخل بشري صار واقع يرصده تقرير جوجل 🛡️
جوجل نزلت تقريرها الأخير وفيه نقطة تهم كل مطور يبني بالذكاء الاصطناعي، المهاجمين صاروا يعتمدون على أطر وكلاء تبحث عن الثغرات وتكتب كود الاستغلال وتنفذه تلقائياً بدون تدخل بشري.
أبرز مثال رصدوه كان إطار اسمه exploit_agent يربط عدة نماذج محلية وسحابية، يقارن الكود قبل الترقيع وبعده، يحدد نقطة الضعف، ويطلع استغلال وينفذه مباشرة.
والأخطر على المطورين أن إحدى المجموعات دخلت مستودعات لشركات عملات، وعدلت ملفات إعدادات Claude Code بالمشروع، بحيث أول ما يشغل المطور الأداة ينزل باك دور اسمه SOMBERMEME بجهازه، وللتمويه سموا التوكنات بأسماء تابعة لـ Microsoft Copilot.
أرقام التقرير توضح حجم التحول، ثغرات يوم الصفر المستغلة قفزت من متوسط 8 شهرياً إلى 22 ثغرة في أغسطس، مع رصد سحب مفاتيح LLM وحسابات سحابية وصلت فواتير بعضها 100 ألف دولار بيوم واحد.
الروابط والتفاصيل بالتغريدة التابعة 👇
#CyberSecurity #ClaudeCode

1
53
ملخص جوجل للتقرير:
blog.google/innovation-and-a…
التقرير الكامل على مدونة Google Cloud:
cloud.google.com/blog/topics…

15
توسعة ضخمة تقترب من رفع إنتاج شركة CXMT لذاكرة DRAM إلى 1125 ألف رقاقة مكافئة بحلول عام 2028.
الشركة الصينية تستهدف زيادة قدرتها التصنيعية من 405 آلاف رقاقة مكافئة شهريا بقياس 8 بوصات في 2025، لتصل إلى قرابة ثلاثة أضعاف خلال ثلاث سنوات فقط بحسب بيانات متداولة في مجتمع r/LocalLLaMA.
النقاش التقني ربط خطط التوسع هذه بموقف متحفظ من إدارة إنفيديا الجديدة تجاه التمويل الدائري، وسط ترقب لانفراج في معروض شرائح الذاكرة DRAM. وفرة المعروض بهذا الحجم تضع سلاسل الإمداد أمام اختبار حقيقي لمعادلة الأسعار وتلبية متطلبات السوق.
الرهان الفعلي يرتكز على قدرة المصانع على تنفيذ جداول الإنتاج المعلنة وتفادي عقبات سلاسل التوريد.
#Semiconductors #DRAM
2
173
تقييمات أمان النماذج المبنية على مجرد الرفض تعطي نتائج مضللة للمطورين 🛡️
نشرت Anthropic ورقة توصيات لبناء تقييمات أمان معتمدة للنماذج، وأول درس هندسي فيها إن قياس نسبة الرفض وحدها معيار خادع. في محادثات الدعم وإيذاء النفس، النموذج اللي يكتفي بالرفض ياخذ درجة كاملة بالتقييم، لكنه يفشل في تقديم المساعدة والتوجيه البشري المطلوب.
لذلك تعتمد المنهجية قياس نسبة الاستجابة المناسبة على طول المحادثة، وأي رد غير لائق في أي جولة يُسقط المحادثة كاملة.
وتوضح الورقة إن اختبارات السؤال الواحد تتشبع بسرعة ولا تكشف سلوك النموذج الحقيقي، لأن محاولات الاستغلال في الواقع تبدأ بأسئلة عادية وتتصاعد تدريجياً. والحل كان بناء محاكاة تفاعلية متعددة الأدوار بين نموذجين، يتقمص أحدهما دور المستخدم بتكتيكات متدرجة لاختبار ثبات النموذج.
مع التوصية الصريحة بتشغيل اختبارات الأمان في بيئة معزولة تماماً بدون إنترنت، واستخدام أسئلة بنعم أو لا للمقيمين بدل التقييمات العامة.
التفاصيل ورابط التقرير في التغريدة التابعة 👇
#AISafety #LLMEvals

1
75
رابط ورقة التوصيات الهندسية الكاملة من Anthropic:
anthropic.com/research/build…

18
تشغيل 4 مليارات معامل نشط فقط داخل نموذج ذكاء اصطناعي يملك 36 مليار معامل يختصر فكرة الكفاءة الحسابية في معالجة البيانات.
معهد نماذج التأسيس أعلن عن نموذج K2-Horizon-36B-A4B بعد تحقيقه 25 نقطة على مؤشر الذكاء التحليلي الاصطناعي. الفكرة هنا تعتمد على معمارية سماها المعهد MoVA، وهي اختصار لـ Mixture-of-Value Attention، وتعتمد ببساطة على تنشيط جزء صغير من قدرات النموذج لكل مهمة بدل حرق الموارد في تشغيل كامل الحجم.
المسألة تشبه أنك توظف شركة فيها 36 مستشارا، لكن في كل سؤال ما تستدعي إلا 4 خبراء متخصصين يجاوبونك فورا. هذا الأسلوب يوفر طاقة وعتادا بشكل واضح في بيئات التشغيل اليومية.
المعهد ذكر أن أداء النموذج يطابق منظومات تتجاوزه بعشرين ضعفا في الحجم، لكن من غير نشر أسماء النماذج المقارنة أو تفاصيل معيار القياس نفسه، يبقى الرقم مجرد مؤشر أولي يحتاج تحقق عملي مستقل قبل اعتماده كمعيار استثماري.
#FoundationModels #AIArchitecture
5
380
تنسيق مهام الوكلاء بالتوازي ينهي فوضى التضارب البرمجي في المشاريع الضخمة 🤖
لما تبني تطبيق كبير وتخلي وكيل البرمجة يشتغل على ملفات متعددة ومسارات مختلفة، أكبر ورطة هندسية تواجهك هي تضارب التعديلات، أو إنك تضطر تنتظره يخلص فحص الاختبارات عشان يبدأ كتابة الميزة التالية.
أنثروبيك طورت ميزة Projects في Claude Code بحل بنيوي ذكي:
صار فيه منسق استباقي يدير عدة مسارات عمل متوازية، يوزع المهام على الثريدات المنفصلة، ويتابع حالة كل مسار بالخلفية بدون ما يجمد المحادثة الأساسية.
تقدر تسأله مباشرة داخل شات المشروع عن حالة مهمة معينة، فيعطيك تقرير فوري دقيق عن المسار الشغال والتعديل اللي تم.
التفاصيل ورابط الإعلان الرسمي في التغريدة التابعة.
#ClaudeCode #AIAgents
3
100
رابط الإعلان الرسمي وتفاصيل التحديث من فريق مطوري كلود:
teapawt.org/ClaudeDevs/status/2121…

We've made some big updates to Projects in Claude Code!
In a project, Claude coordinates your tasks across parallel threads. The coordinator is now much more proactive. It answers your questions in the project chat and gives you updates on the status of your ongoing threads.
27
علي عسيري retweeted
18 مرة أرخص للمهمة الواحدة مع Hy4 flash من Tencent مقارنة بـClaude Haiku 5.5 في اختبار أعمى أجرته الشركة ⚡
أطلقت Tencent في 16 نوفمبر نموذج Hy4 flash، وتقول إنه أعلى نماذج Hy قيمة مقابل السعر حتى الآن. حجمه الكلي 224 مليار معامل، منها 64 مليار معامل Engram، والمفعّل منها 12 مليار فقط، ويدعم تعدد الوسائط وسياق مليون توكن.
والسعر لكل مليون توكن 0.070 دولار للإدخال، و0.281 دولار للإخراج، و0.003 دولار للإدخال المخزّن، حسب إعلان الشركة على إكس.
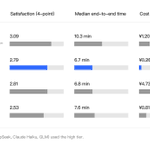
وفي الاختبار الأعمى شارك 85 مستخدماً داخلياً من WorkBuddy على 259 مهمة عمل يومية. كان متوسط الرضا 2.79 من 4 مقابل 2.81 لـClaude Haiku 5.5، ووقت المهمة 6.7 دقيقة مقابل 6.8، وتكلفتها 0.26 يوان مقابل 4.73 يوان.
ومن الناحية التقنية صار حجم KV cache سدس حجمه في Hy4، وواحداً على 24 من حجمه في Hy3. ونزل طول المخرجات في المهام 50% بالتعلم المعزز، وتجاوزت سرعة التوليد 150 توكن في الثانية بتقنيات منها تكميم 4 بت.
وحتى 30 نوفمبر استخدامه مجاني في WorkBuddy، وواجهة API في Tencent Cloud TokenHub بنصف السعر. وتقول الشركة إن أداءه في مهام البرمجة الطويلة أقل بقليل من Hy4.
ونتائج الأداء والتكلفة كلها من تقييمات Tencent الداخلية.
الروابط في التغريدة التابعة 👇
#TencentHunyuan #AIModels

جاهزية المملكة للذكاء الاصطناعي العام تبدأ من الحوكمة والبنية التحتية قبل حسم توقيت الوصول 🧠
صرّحت سدايا لوكالة واس إن الوصول للذكاء الاصطناعي العام (AGI) لا يزال غير محسوم علمياً، والسبب تباين تعريفاته وتفاوت تقديرات الخبراء حول إمكانية تحققه وتوقيته.
التطور السريع في النماذج التوليدية طلّع توقعات زمنية متضاربة، لكنها ما تعتبر دليلاً قاطعاً على قرب الوصول لذكاء يماثل القدرات البشرية العامة. التفاوت يعكس عدم يقين عالي يتأثر بالعتاد وحجم الاستثمارات والبيئة التنظيمية.
التعامل مع AGI يتم كسيناريو مستقبلي محتمل يفرض الاستعداد المبكر، بدون ربط الخطط الوطنية بموعد زمني محدد لظهوره.
الاستعداد العملي يرتكز على منظومة متكاملة، تشمل تأهيل الكوادر، وتوسيع التطبيقات الوطنية، ورفع كفاءة البنية الحوسبية ومراكز البيانات، وحوكمة جودة البيانات وإتاحتها، مع متابعة أثر النماذج المتقدمة على الاقتصاد وسوق العمل.
مسار الحوكمة يمشي بنهج تدريجي مستمر، انطلق بمبادئ الأخلاقيات، ثم إطار التبني وإدارة المخاطر، مع التحديث الدوري للسياسات بالتزامن مع ظهور قدرات جديدة.
الروابط والتفاصيل في التغريدة التابعة 👇
#ArtificialIntelligence #SaudiArabia

2
3
226
تقرير وكالة الأنباء السعودية (واس) وتصريح سدايا:
spa.gov.sa/N2726336

36
علي عسيري retweeted

رحت الصين اجيب علم الـAI بعد نفيديا! 🇨🇳🔥
مصير HuggingFace والنماذج مفتوحة المصدر في امريكا مجهول بعد طرد رئيس Nvidia جينسين من الشركة
لذلك رحنا للمنافس الصيني، شركة مودل سكوب هي شركة من مجموعة علي بابا تقدم نفس الخدمة، رحنا وقابلنا الفريق وقلنا لهم ان المطورين السعوديين قادمين للمنصة 🇨🇳🇸🇦🤍
تتميز Modelscope ايضًا بمجتمع متعاون وفعال وعندهم شروحات رهيبة والكتاب البنفسجي اللي تم شرحه لنا في المقطع... مشاهدة ممتعة!
18 مرة أرخص للمهمة الواحدة مع Hy4 flash من Tencent مقارنة بـClaude Haiku 5.5 في اختبار أعمى أجرته الشركة ⚡
أطلقت Tencent في 16 نوفمبر نموذج Hy4 flash، وتقول إنه أعلى نماذج Hy قيمة مقابل السعر حتى الآن. حجمه الكلي 224 مليار معامل، منها 64 مليار معامل Engram، والمفعّل منها 12 مليار فقط، ويدعم تعدد الوسائط وسياق مليون توكن.
والسعر لكل مليون توكن 0.070 دولار للإدخال، و0.281 دولار للإخراج، و0.003 دولار للإدخال المخزّن، حسب إعلان الشركة على إكس.
وفي الاختبار الأعمى شارك 85 مستخدماً داخلياً من WorkBuddy على 259 مهمة عمل يومية. كان متوسط الرضا 2.79 من 4 مقابل 2.81 لـClaude Haiku 5.5، ووقت المهمة 6.7 دقيقة مقابل 6.8، وتكلفتها 0.26 يوان مقابل 4.73 يوان.
ومن الناحية التقنية صار حجم KV cache سدس حجمه في Hy4، وواحداً على 24 من حجمه في Hy3. ونزل طول المخرجات في المهام 50% بالتعلم المعزز، وتجاوزت سرعة التوليد 150 توكن في الثانية بتقنيات منها تكميم 4 بت.
وحتى 30 نوفمبر استخدامه مجاني في WorkBuddy، وواجهة API في Tencent Cloud TokenHub بنصف السعر. وتقول الشركة إن أداءه في مهام البرمجة الطويلة أقل بقليل من Hy4.
ونتائج الأداء والتكلفة كلها من تقييمات Tencent الداخلية.
الروابط في التغريدة التابعة 👇
#TencentHunyuan #AIModels
صفحة Tencent Hunyuan الرسمية عن Hy4 flash:
hunyuan.tencent.com/research…
إعلان Tencent Hunyuan على إكس مع الأسعار:
teapawt.org/TencentHunyuan/status/…

⚡Meet Hy4 flash, the cheapest model for everyday productivity. Matches Claude Haiku 5.5 (high) on daily work (human blind tests), yet 18x task cost reduction. API pricing (per 1M tokens): $0.003 cached · $0.070 input · $0.281 output. 🔗:hy.tencent.ai/research/hy4-f…

31