






➡️ Lieliska iespēja piedalīties darbnīcā, kur tiks demonstrēts projektā DigiLATE (digitalhumanities.lv/lv/proj…) pilnveidotais LATE runas atpazīšanas un transkribēšanas rīks (late.ailab.lv). hzf.lu.lv/par-mums/lu-mediji…
Tikko noslēgusies pasaulē nozīmīgākā runas tehnoloģiju konference #Interspeech2026, kas šogad norisinājās Sidnejā: interspeech2026.org
Ar lepnumu ziņojam, ka tajā ar referātu "Low-Resource Medical ASR for Rich Transcription in Latvian" piedalījās mūsu pētnieks Artūrs Znotiņš. Viņš prezentēja #ITKC pētniecības projekta rezultātus, kas tapuši LU MII sadarbībā ar SIA "DATI Group", SIA "ASSISTENTIS" un SIA "Viroling Technology", attīstot runas transkribēšanas MI risinājumu Latvijas veselības aprūpes nozarei.
Publikācija: isca-archive.org/interspeech…


📌Jona Jablonska 31. starptautiskajā zinātniskajā konferencē "Kalba kaip sistema ir procesas" (Valoda kā sistēma un process), kas notiek 1.–2. oktobrī Viļņā, AiLab pārstāv:
▫️ Ilze Lokmane ar referātu "Čumēt un mudžēt, aijā žūžū, kling klang un citi: vairākvārdu leksēmu tipi elektroniskajā vārdnīcā Tēzaurs" un
▫️ Paula Miķelsone ar referātu "Fonētiskā realizācija salikteņu komponentu robežā".

🇱🇻CLARIN-LV komanda piedalās CLARIN Annual Conference 2026!
Šonedēļ Braitonā, Apvienotajā Karalistē, notiek ikgadējā CLARIN konference, kas pulcē valodas resursu, valodu tehnoloģiju un digitālo humanitāro zinātņu pētniekus, kā arī digitālās infrastruktūras veidotājus no visas Eiropas.
Latviju konferencē pārstāv Inguna Skadiņa, Roberts Darģis, Ilze Auziņa no LU Matemātikas un informātikas institūta Mākslīgā intelekta laboratorijas un Latvijas Universitātes doktorants Milans Hoplīčeks.
Trijās konferences dienās gūtas jaunas idejas, piedzīvotas vērtīgas diskusijas ar kolēģiem un izmantota iespēja dalīties ar Latvijas pieredzi valodas resursu un tehnoloģiju attīstībā. Priecājamies būt daļa no aktīvās un daudzveidīgās CLARIN kopienas! 🌍
clarin.eu/event/2026/clarin-…
#CLARIN2026 #CLARINLV #CLARIN #AiLab.lv #LanguageResources #LanguageTechnology #DigitalHumanities

📌No 29. septembra līdz 3. oktobrim Vīnē, Austrijas Zinātņu akadēmijā, norisinās EURALEX 22. starptautiskais kongress “Lexicography in the Age of AI” (Leksikogrāfija mākslīgā intelekta laikmetā), kurā piedalās AiLab pētniece Gunta Nešpore-Bērzkalne.
🟢 29. septembrī Gunta referātā “Stabilu vārdu savienojumu atspoguļošanas iespējas elektroniskajā latviešu valodas vārdnīcā “Tēzaurs”” stāstīja par to, kā vārdnīcā tiek atspoguļoti stabili vārdu savienojumi (frazeoloģismi un citi izteicieni) un kāda informācija par tiem ir uzkrāta. Īpaši iepriecināja klausītāju atzinīgie vārdi par šo vārdnīcu kā apjomīgu leksikogrāfisko resursu, kāda nav pat valodām ar lielāku runātāju skaitu. #EURALEX2026


📚 Interesanta lasāmviela – "Tour de CLARIN" 6. sējums, kas veltīts jaunajiem zinātniekiem. Tajā dažādu valstu doktoranti stāsta par pētījumiem, kuros izmantoti CLARIN valodas resursi un rīki. AiLab.lv zinātniskā asistente un RTU Liepāja doktorante Guna Rābante-Buša ne tikai iepazīstina ar saviem doktorantūras pētījumiem, bet arī stāsta par runātās valodas resursiem un rīkiem CLARIN-LV repozitorijā (piem., LATE korpusiem) un Balsu talkas iniciatīvu. office.clarin.eu/v/CE-2026-2…

🎉 Rudens atnesis ne tikai jaunus šķirkļus, bet arī xn--tzaurs-p3a.lv Instagram kontu (instagram.com/tezaurs.lv), kur dalīsimies jaunumos, skaidrosim, kā top elektroniskā latviešu valodas vārdnīca, ko tajā var atrast, un stāstīsim par dažādām xn--tzaurs-p3a.lv izstrādātāju – LU MII Mākslīgā intelekta laboratorijas – aktivitātēm.
🍁“Tēzaura” rudens versija ir klāt!
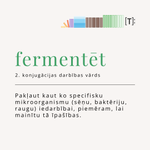
Kopumā tiešsaistes vārdnīcas lietotājiem tagad pieejami 415 514 šķirkļi, un arī šoreiz jauno un uzlaboto šķirkļu klāstā ietilpst lietotāju ieteikumi, kas iesūtīti iniciatīvā “Iesaki vārdu!”. Vārdnīcā citu starpā iekļauti tādi ieteiktie šķirkļi kā “fermentēt”, “vikšķerēšana”, “flīss”, “limončello”, “lopsēt” un “tīklošanās”.
Šoruden uzsākti darbi pie vērienīgākas ieteikumu ieviešanas “Tēzaurā”, tāpēc jau drīzā nākotnē vārdnīcas saturs kļūs vēl daudzveidīgāks. Pateicamies visiem iniciatīvas dalībniekiem!

AiLab vadošais pētnieks un Latvijas Universitātes Matemātikas un informātikas institūts direktors Roberts Darģis taujāts par to, vai mākslīgais intelekts mums pieliks punktu desmit gadu laikā, norāda: "Varbūtība satikt uz ielas pūķi ir tāda pati kā varbūtība, ka mākslīgais intelekts sacelsies pret mums." Plašāku sarunu par MI straujo attīstību un tās radītajām bažām var izlasīt DELFI Tehnoloģiju sadaļā: delfi.lv/campus/56036808/teh…

🎉 Lepojamies, ka latviešu valodas dati iekļauti starptautisku datorlingvistikas sacensību SemEval-2027 (semeval.github.io/SemEval202…) uzdevumā. Ailab pētnieces Gunta Nešpore-Bērzkalne un Agute Klints izveidojušas idiomātisku vārdu savienojumu un to pārfrāzējumu kopu, kura kopā ar 12 citu valodu kopām tiks izmantota, lai noteiktu rīku spēju identificēt tekstā idiomu un aizstāt to ar citu frāzi, nezaudējot saturu (plašāk sk. unidive.lisn.upsaclay.fr/dok…)

8.–9. septembrī Sofijā, Bulgārijā, notika 7. starptautiskā datorlingvistikas konference Computational Linguistics in Bulgaria (#CLIB2026). Tajā ar Guntas Nešpores-Bērzkalnes, Mikus Grasmaņa un Ilzes Lokmanes kopreferātu Multi-word Expressions in the Electronic Dictionary Tēzaurs: Integrating Data from Different Sources (“Vairākvārdu leksēmas elektroniskajā vārdnīcā Tēzaurs: datu iekļaušana no dažādiem avotiem”) piedalījās G. Nešpore-Bērzkalne un I. Lokmane.

No 1. līdz 4. septembrim Brno, Čehijā, aizvadīta starptautiskā zinātniskā konference “Text, Speech and Dialogue” (#TSD2026). Ar stenda referātu “Large-Scale Computational Morphology and Lexical Resources for Latvian and Latgalian” tajā piedalījās laboratorijas pētniece Lauma Pretkalniņa.

27.–28. augustā Gunta Nešpore-Bērzkalne piedalījās UniDive (COST CA21167) 4. sanāksmē Rumāņu akadēmijas Mākslīgā intelekta institūtā Bukarestē.

ALT Sanāksmē G. Nešpore-Bērzkalne prezentēja pētījumu "PARSEME ieguldījums elektroniskās vārdnīcas Tēzaurs papildināšanā" (“The Contribution of PARSEME to Enhancing the Electronic Dictionary Tēzaurs”).

ALT G. Nešpore-Bērzkalne iesaistījusies starptautiskā iniciatīvā PARSEME un rūpējusies par latviešu valodas datu sagatavošanu PARSEME 2.0 (Multilingual Corpus of Multiword Expressions) korpusa laidienā. Par to stāstīts referātā “PARSEME corpus 2.0 and shared task on automatic identification of multiword expressions”.

ALT Par stabilu vārdu savienojumu korpusu un to automātisku noteikšanu sīkāk stenda referātā “PARSEME corpus and shared task on automatic paraphrasing of multiword expressions”.
AiLab zinātniskā asistente, RTU Liepāja doktorante Guna Rābante-Buša intervijā CLARIN Newsflash: clarin.eu/blog/tour-de-clari…

Paldies visiem, kas iesaistījās projekta ParRuna aptaujā par vārdu izrunu. Aptaujas rezultāti nu ir APKOPOTI, un tos var aplūkot: parruna.app.ailab.lv/anketa/…. Kā izrādās, lielākā daļa no jums spēj sadzirdēt vārda “riet” izrunas atšķirības izteikumos “saule riet” un “suns sāka riet”. Vai saklausīji pareizo variantu? Izpēti arī citus heterotonus – vienādi rakstāmus, atšķirīgi izrunājamus vārdu pārus!
ES🇪🇺 investē miljardus MI🤖 pētniecībā un inovācijās, HPC⚙️ skaitļošanas infrastruktūrās. Taču tehnoloģiju izrāvienam ir nepieciešami arī kvalitatīvi, daudzveidīgi valodas dati.
Kam pieder dati? Kā panākt, lai visas puses ir ieguvēji? Vai Eiropas datu tirgus izveide ir iespējama?
Par to 22. maijā stāstīs un diskutēs publiskā, privātā un akadēmiskā sektora pārstāvji Eiropas Valodas datu telpas seminārā Rīgā: language-data-space.ec.europ…
Aicinām ikvienu interesentu piedalīties!
Norises vieta: VARAM, Peldu ielā 25
Reģistrācija un dalība: bez maksas
Semināra darba valoda: latviešu


27. martā LU Matemātikas un informātikas institūtā notiks literārajiem redaktoriem paredzēts seminārs. Publicējam programmu un vēl līdz 23. martam aicinām pieteikties saitē ej.uz/seminarsnorma. Vairāk par projektu: norma.korpuss.lv #FLPP
