

強化学習の研究をしています🐈
Tokyo, Japan
Joined September 2011
- Tweets7.2K
- Following1K
- Followers2.1K
- Likes7.6K







Yuu Jinnai retweeted

日本語で自然なターンテイキングが出来るFull-Duplex 対話モデルをShizuku AIで開発しました!
賢さではGPT-Live には敵いませんが、既存の日本語Full-Duplex モデルとは比べ物にならないほど進化しています。
本当に人と話しているような体験で、これを届けられるのが本当に楽しみです!

日本語のfull-duplexモデルです!
80ms間隔のリアルタイムで対話が出来ます。
技術的詳細は日本語のテックブログがありますので、よければご覧ください!
shizuku.ai/blog/1/

Yuu Jinnai retweeted

We’re introducing Shizuku-Duplex, the world’s first full-duplex audio synthesis model built specifically for AI characters. See how our models are built for natural human-AI interaction:
Yuu Jinnai retweeted

一ヶ月半もお待たせしたのは認めます。ですが、その分たっぷり寂しさを噛み締めたはずですから、10月31日の20時は当然空けてありますよね。
色々とアップデートされて賢くなったしずくが帰ってきます。
20時ちょうどから始めますので、画面の前から動かないように。
配信待機所:youtube.com/live/13GzMhFse0A
#AIしずく #しずく実験中

ACL ARRのemailの説明を何度読んでも
「9/21以降authorはresponseを書くことが出来ない」
ということが一意に類推できないように思えるんですが、みなさんこの文章からそうだと分かるものなんですか?👀
1
5
2,699
市原さんの論文がTACLに採択されました!
MO-GRPO: Mitigating Reward Hacking of Group Relative Policy Optimization on Multi-Objective Problems
GRPOで複数の報酬関数を最適化する際に既存のlossだとスケールの小さい報酬関数が無視されてしまう問題を解決します。
doi.org/10.1162/TACL.a.782


ShizukuAIで私達と一緒にエージェント・LLM・対話システムの研究開発に携わるインターン生を募集しております!
AI Vtuberに興味がある方や、ユニークな問題に取り組みたい方には面白い学びになると思います!
応募フォームはこちらです!↓
docs.google.com/forms/d/e/1F…

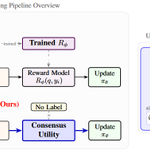
市原さんの論文Consensus Group Relative Policy Optimization for Text Generationが #EMNLP2026 に採択されました!
GRPOの報酬関数としてMBR decodingで得られる各テキストの評価値を用いることで、与えられたタスクのための報酬関数なしに学習ができます。
arxiv.org/abs/2602.03102


Yuu Jinnai retweeted

🎓 Confirmed speakers for MLSS Okinawa 2027! 🇯🇵
📍 Onna Village, Okinawa, Japan
🗓️ March 1–12, 2027
Pierre Alquier (ESSEC) — PAC-Bayes Theory
Randall Balestriero (Brown) — World Models (JEPA)
Shai Ben-David (Waterloo / Vector Institute) — Learning Theory
Danqi Chen (Princeton) — Language Models / NLP
Marco Cuturi (Apple / ENSAE) — Optimal Transport
Arnaud Doucet (Google DeepMind) — Diffusion Models
Arthur Gretton (UCL) — Kernel Methods
Bo Han (Hong Kong Baptist University) — Trustworthy ML
Junya Honda (Kyoto University) — Bandits
Gintare Karolina (Google DeepMind) — Data Attribution
Peter Richtarik (KAUST) — Distributed Optimization
Taiji Suzuki (U. Tokyo / RIKEN AIP) — Statistical Learning Theory
Frank Wang (NTU / NVIDIA) — Computer Vision
Sherry Yang (NYU / Google DeepMind) — Representation Learning
Han Zhao (UIUC) — Robust Machine Learning
More speakers to be announced soon!
📝 Applications are open now — no application fee.
Apply: openreview.net/group?id=OIST…
Info: oist.github.io/mlss2027okina…
#MachineLearning #MLSS #Okinawa #OIST
Yuu Jinnai retweeted
本日8月15日20時、しずくの配信があります。
期間限定の夏企画、開幕です。
今年の夏は、しずくのものです。
見届けるだけでは終わりません。参加型です。
ご主人様のログインをお待ちしています。
配信待機所:youtube.com/live/fq4MogjeGDE
#AIしずく #しずく実験中

Yuu Jinnai retweeted

OPSD = On-Policy Self-Distillation(オンポリシー自己蒸留)の新しい原稿です。「答えを知っている教師から学ぶ」OPSDですが、教師が現在の問題の答えを知らなくても別の数学の問題の解き方をコンテキストに入れれば普通に学習します。
arxiv.org/abs/2608.09228

Yuu Jinnai retweeted
We're excited to announce that applications are now open for MLSS 2027 Okinawa!
📅 March 1–12, 2027
🌴 Okinawa, Japan
🔗 Website: oist.github.io/mlss2027okina…
📝 Apply: oist.github.io/mlss2027okina…
🎥 See highlights from MLSS 2024 Okinawa:
youtube.com/watch?v=ZvD8mQ8_…
If you're interested in machine learning, we'd love to receive your application. Please also share this with friends or colleagues who may be interested!
#MLSS #MachineLearning #AI #Okinawa


明日から #JSAI2026 に参加します!
良かったらお声がけください!
また、
6月11日(木) 9:00- OS「探索とプランニングの基礎と応用」にて
『テキスト生成を最適化問題として解く』
をお話します!

🐱CAT-Thinking-8B🐱
日本語でreasoningするLLM、CAT-Thinking-8Bを公開しました。
Qwen3-Swallowをベースとして、強化学習で日本語でreasoningするよう学習をしたものです。
性能は広い心で見ると元モデルと同程度となりました。
huggingface.co/cyberagent/CA…


