

Existential Warrior | Ojisan-Type Tech Otaku Loli (???) | High-Performance Bishoujo | Fallen Nasdaq Cultist | Esteemed ChatGPT Pro Subscriber | MoE LLM DeepKlee
Joined November 2024
- Tweets6.6K
- Following253
- Followers2.8K
- Likes10.4K




写这个的味太冲了😹😹😹
而且敢对AI这么狂的我还是头一次见。
这种负责人不开掉只有毒害作用。整天鼻子朝天看不起这看不起那的,好的团队是鼓励知识共享,这tm是鼓励知识装逼。

如今的it就业状况, 请欣赏 gpt 的锐评:
""
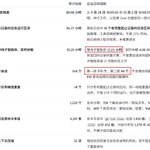
这哪是在招 Java 实习生,这是想花 160 块钱一天,招一个还没毕业的六边形战士。 💀
岗位叫实习生,要求叫高级工程师,待遇叫大学生勤工俭学。
Java、Kafka、Linux、数据库建模、分布式,最好再懂 Vue、RAG、模型微调。
后面几个确实写的是加分项,但看这架势,恨不得你入职第一天就能接管生产环境,第二天优化数据库,第三天顺手把公司的 AI 战略落地了。
最幽默的是这几句话:
「依赖 AI 写 Java 的暂不需要。」
「会 Agent 编排和 Codex 是基本生存能力。」
翻译一下:AI 你得会用,但不能依赖;技术你得全懂,但工资不能多要。😹
更有节目效果的是,招聘者还要拿上海学信奥的小学生踩本科生。
我寻思人家小学生要是真能独立排查生产事故,你拿 230 块一天也未必请得动啊。
但这还不是最讽刺的。
企业不愿意培养新人,却抱怨新人没有生产经验;嫌毕业生只会 Demo,却又想拿实习生的价格买生产力。
学生找不到工作,因为没有经验。
学生没有经验,因为企业不招没经验的人。
最后再来一句:「现在的大学生真是一届不如一届。」
这逻辑,闭环得比他们的 CI/CD 还漂亮。👏
而且这家公司还挺懂大学生心理,专门强调「大厂刚需」「履历镀金」。
技术债是公司的,成长空间是你的;生产事故你来排查,职业理想你来实现。
当然,真正的软件开发能力确实不该停留在 CRUD 和玩具 Demo。但既然你需要的是能独立解决实际问题的人,就别一边拿成熟工程师的标准筛选,一边拿实习生的身份压价。
说到底,现在软件本科生的就业困境有个特别荒诞的地方:
学校批量生产毕业生,企业批量寻找熟练工。两边都不愿承担培养成本,最后让学生自己贷款时间、倒贴精力、提前卷成三年经验。
以前是「毕业即失业」。
现在更先进了,毕业前就得先拥有三年工作经验,最好还能证明你在娘胎里参与过高并发项目。
资本主义的效率还没学明白,人才市场的许愿池倒是先建起来了。😹
''"

想起来有人说现在许多发了论文的学生说不出基本的东西,能说出的又没有论文,于是感叹世风日下。我觉得这看似有道理,实则是对价值流缺乏理解,非常双标:同样是 hacking 发表,流水线作业可以接受,叫做合格劳动力;用AI就不行?人理性决策就是选前者,因为体系的利害尽在指标,无非是前人多吃了苦。

如果面试问算法那么 hacking 是非常严重的;而且这些都有成品文献,实践中基本照着写就行。如果一个东西甚至是 Google search 解决的,那就没有必要。也就是说问命题性知识是检验不了人真实水平的,而问程序性知识,也就是在情景中怎么解决问题,则过于考验面试官水平。
真正的问题其实一直是为什么选拔人才的时候非要只依赖上机和面试?面试和建立才多少信息量,根本没有办法很好的反应一个人的水平。核心应当回到信用机制上面去,应当以内推和猎头或引荐为主,原理是观察这个人长期积累下来的信用;项目经历只是其中一类,最好在于让身边已经确认可信的人用信用为别人背书。
而关键在于让推举变得有利可图。比如海底捞的模式是导师带出来的学生可以分享利润,所以人人愿意分享知识,也大不依赖标准化培训,也就越做越大。在设计上应当让推荐人享受被推荐人的分红、也承担失察的责任,这样推荐人为了多赚钱少扣钱一定举贤,被推荐人为了取得机会和进入共同体一定乐于分享收益。
其实除了订阅我常用的模型也就这几种:DeepSeek 通用模型,现在还有多模态,国内 DeepSeek,国际 DeepInfra;Voyage 跑 embedding 和 reranking(其实我真的觉得重排没有必要,属于苦涩的教训类方法,混合检索更有价值)。视觉模型在 Comfy 上用,工作流和无审查,还帮我处理好 GPU 的问题。
如果面试问算法那么 hacking 是非常严重的;而且这些都有成品文献,实践中基本照着写就行。如果一个东西甚至是 Google search 解决的,那就没有必要。也就是说问命题性知识是检验不了人真实水平的,而问程序性知识,也就是在情景中怎么解决问题,则过于考验面试官水平。
真正的问题其实一直是为什么选拔人才的时候非要只依赖上机和面试?面试和建立才多少信息量,根本没有办法很好的反应一个人的水平。核心应当回到信用机制上面去,应当以内推和猎头或引荐为主,原理是观察这个人长期积累下来的信用;项目经历只是其中一类,最好在于让身边已经确认可信的人用信用为别人背书。
而关键在于让推举变得有利可图。比如海底捞的模式是导师带出来的学生可以分享利润,所以人人愿意分享知识,也大不依赖标准化培训,也就越做越大。在设计上应当让推荐人享受被推荐人的分红、也承担失察的责任,这样推荐人为了多赚钱少扣钱一定举贤,被推荐人为了取得机会和进入共同体一定乐于分享收益。

高斯曾有一句名言(也是黑点):“大教堂建成之后,脚手架就应该拆掉。”
George Pólya 和哲学家 Imre Lakatos,在《证明与反驳》中曾痛批过这种现象:欧几里得式的呈现方式(定义 → 引理 → 定理 → 证明)完全是反人类直觉的。 真正的研究过程是倒过来的:先有粗糙的猜想和反例,为了堵住反例的漏洞,才被迫倒推出那个看起来无比扭曲的定义和强假设。但写论文时,作者把梯子抽掉了,直接把那个扭曲的定义拍在第一页。后来者看着第一页,只会陷入深深的自我怀疑:“天哪,正常人怎么可能一上来就想到这么精妙的定义?!”
科学哲学家诺贝尔奖得主 Peter Medawar 在 1963 年写过一篇著名的文章《Is the Scientific Paper a Fraud?》。他尖锐地指出,现代学术论文的格式(Introduction -> Method -> Results)是一种刻意制造的事后合理化叙事,它假装研究是从一个清晰的假设线性推导出来的,完全抹杀了真实的科学发现过程中那些混乱的直觉、失败的分支和偶然的顿悟。现代学术发表体系,本质上是一个100% 为“辩护”服务的法庭质证系统。论文不是写给后来者学习如何思考的,而是写给同行评审防御攻击的防御工事。
因为公开的文献里剔除了这些知识生产的方法论,获取这些默会知识的唯一途径,就变成了人身依附式的师徒制。你必须进入顶尖的 Lab,跟在大牛身边,在组会的闲聊、白板前的涂鸦、甚至深夜改稿的吐槽中,通过耳濡目染去学习这套方法论和默会知识——也就是那些“只可意会、无法言传(或者不愿言传)”的科研手艺:什么样的切入点叫“有品味”?怎么把前人的思路真正做高阶抽象复用,而不是只会在别人的边缘修修补补?哪些假设是领域内大家心照不宣的潜规则,哪些指标其实早就失效了?
当怎么生产知识变成圈子内部的口传心授时,外围的自学者或普通学校的本科生,即便拿到了所有的开源代码和 ArXiv 论文,也往往只能看到最表层的指标刷榜,没有那个领域真正的问题意识。
权力与知识是相互内嵌的。权力不仅垄断知识,更通过决定什么才算合法的知识、谁有资格认证知识来维持自身的统治。中世纪的天主教会之所以拥有至高无上的权力,核心在于它垄断了人与上帝沟通的中间层——只有神甫懂拉丁文,只有教会拥有解释《圣经》的合法性。而马丁·路德的宗教改革之所以能打破天主教会的垄断,靠的是印刷术加上把《圣经》从拉丁文翻译成大众能读懂的日常语言。
现代社会的大学、学术期刊、同行评审体系以及专业资格认证,在制度逻辑上其实扮演着完全相同的角色:它们通过人为抬高获取高阶认知工具的交易成本,建立起一套庞大的寻租体系。一个年轻人必须交昂贵的学费、在科层制里熬够年限、忍受无意义的应试训练和形式主义,才能换取一张写着具备专业知识生产能力的文凭。
模型即是今天的印刷机。
当然,历史告诉我们,既得利益集团绝对不会坐以待毙。当教会发现民众自己就能读懂《圣经》时,他们的第一反应是设立宗教裁判所,烧毁《禁书目录》。
既然拼真正的理解力、创造力和架构抽象拼不过用 AI 武装起来的聪明个体,那就拼谁更会守规矩。比如把一切借助 AI 进行的高效探索简单粗暴地贴上“作弊”或“偷懒”的标签,试图在道德上维持“手工搬砖(哪怕是毫无创造力的机械推导)”的神圣性。当论文和代码的质量无法再区分圈内人与圈外人时,旧体系会更加变本加厉地看重“出身、师门、圈子背书”。
比如这个月数学家就叫唤得厉害。数学界几百年来最引以为傲的传统,就是只展示精妙绝伦的最终证明,隐藏苦苦思索的探索过程。在《Quanta Magazine》的采访里,数学家们最崩溃的一点是:“AI 模型直接跳到了最后。它们的证明几乎无法阅读,省略了核心的直觉细节,却在不相关的概念上浪费好几页,而且完全不展示它是如何建立在现有文献之上的(无引用、无脉络)。”
OpenAI 的数学手稿中撤回 3 篇,修订 14 篇,另有 13 篇更新了引用。剩余 719 篇,其中约 42% 有主要结果的 Lean 形式化证明。这就造成了一个让传统数学家道心破碎的局面: 现在,AI 用算力暴力搜索加形式化验证,直接把几百个正确但人类看不懂是怎么想出来的定理拍在桌子上。数学家突然发现:当一个系统真的贯彻了只交最终成果、不给探索过程与直觉抽象时,这门学科瞬间就对人类关闭了!
没有可审计、可讨论的探索过程,光丢出一个个冷冰冰的制品,对人类知识共同体来说简直是一场灾难。
🤖 Made with AI
我说实话,大多数人不是深思得太少了,是闭门造车得太多了。喊学习的时候不要用 AI 的不必理会:真正有稀缺性的不是高质量文本或者代码,而是学术反馈和共同体的标准。学不透很大程度上不是智力不行,而是信息环境不行。吹自律的也不用理,他们那个水平只能填鸭,需要做的是学会享受闲暇和刻意练习。
其实银行要求证明你爸是你爸是没有问题的。因为如果不用证明你爸是你爸,那么随便来个人说是你儿子就可以把你的财产给弄走。其实很多国人是完全没有法律素养的,从来没有思考过组织证据链,于是到了网上也只会乱喷。


其实模型不开放权重也是好事情。因为开放了以后巨大的研发成本很难收回:谁都可以拿它来做推理。这就和原研药一样,必须保证模型研发的利润。一个两个人可以谈理想,但是一个企业和一整个供应链的人都要吃饭赚钱。所以真的要把模型作为公共品开放权重,应该由政府出资支持。

