
60歳からPythonを学び、データ分析や生成AIを活用した教育支援サービスの開発に取り組んでいます。Kaggle Expert(銀2・銅5)/SIGNATE Master。教育データ分析コンテスト入賞。いくつになっても学び、つくり、挑戦する。趣味はダンス(LOCK・POP)、XG推し。アイコンは娘作。
千葉県
Joined October 2009
- Tweets742
- Following703
- Followers3.7K
- Likes2.2K
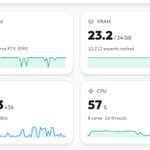




Qwen3.8-Flash-NextをRTX3090 24GBx1でStrata経由、Claude Codeに接続して実プロジェクトを調査させてみた。
「英作文AI評価の処理フローを調査して」と指示しただけで、複数ファイルを横断し、
・入口route
・OpenAI API呼出箇所
・ルーブリック取得
・DB保存
・レビューまでの処理フロー
を特定。さらにコード上の不整合候補まで指摘した。
128K context、RTX3090 24GBで、最終リクエストのdecodeは76.6 tok/s。
ローカルLLMが「チャット」ではなく、かなり実用的なCoding Agentとして使えるところまで来ている。

Strata + Qwen3.8-Flash-NextをRTX 3090 24GBで試してみました。
・IQ3_XXS
・Context 128K
・KV 8bit / KV streaming
・RTX 3090 24GB(250W制限)
・RAM 96GB
実チャットで 73.4 tok/s。VRAM 23.2GB。
Ornith-1.5-35B-A3BをRTX 3090 24GB+RAM 96GBで検証。LM Studio+Continue、32K context、KV Q4で約28~31 tok/s。速度はQwen3.8-27Bとほぼ互角で、単発の分析・コード生成もかなり優秀でした。
一方、実プロジェクトのCoding Agentでは処理のループや本来のタスクから外れるケースが発生。また、日本語で指示しても回答に中国語が混在するのが気になりました。
速度・品質とも期待以上でしたが、日常的に使うCoding AgentとしてはQwen3.8-27Bの方が安定。当面は Claude+Qwen で運用します。
35B MoEが3090一枚でここまで動くのは魅力的なので、今後の改善には期待です。
中古RTX 3090+ローカルLLMは、本当に実務で戦力になるのか?
Qwen3.8-27Bを使った実証実験を続けています。
今回、一つ面白い結果が出ました。
Kaggle「AI Agent Security」で
180位 / 4,186チーム、銀メダル🥈
ChatGPT・Claudeを中心に、ローカルQwenにも調査や実装を分担してもらいました。
私が知りたいのは、「QwenはClaudeを超えられるか?」ではありません。
クラウドAIとローカルAIを役割分担させることで、人間一人では難しかった仕事を、どこまで進められるのか。
中古RTX 3090+27B級LLMという比較的低コストな環境でも、実務の「戦力」を作れるのか。
ベンチマークではなく、実際の仕事やKaggleで検証を続けます。
Kaggle「AI Agent Security」で銀メダルを獲得しました🥈
今回強く感じたのは、自分一人の能力よりも、生成AIとどう協働して成果につなげるかの重要性です。
ChatGPTと戦略や仮説を議論し、ClaudeやローカルLLMにも調査・検証を分担してもらい、人間である私は結果を見ながら次の方向を判断する。
実際、生成AIがなければ、私一人では気づけなかった不具合や、思いつかなかった改善案が数多くありました。
自分に足りない能力をAIに補ってもらうことで、これまでなら届かなかった成果に挑戦できる。今回の銀メダルは、その一つの実証になったと思います。
Kaggleは正解が用意された演習ではなく、世界中の参加者と競い、最後は未知のデータや環境で結果が決まります。
だからこそ、生成AIやAI Agentをどう使いこなし、成果につなげるかを試す実践の場としても、とても面白い。
一方で、考えることもあります。
私はすでに定年し、あと3年ほどで70歳です。限られた時間の中では、自分に不足する能力をAIに補ってもらい、最終的な成果を出すことに集中する、という考え方ができます。
しかし、これから専門性や思考力を身につけていく若い人まで、成果だけを求めて、思考そのものを常にAIへ委ねてしまってよいのだろうか。
AIに任せるべきことと、人間が自分で考えるべきこと。
その境界については、生成AIがさらに進化・普及する中で、これからベストプラクティスが作られていくのでしょう。
答えがまだ定まっていない、こんな混沌とした時代に立ち会えていることを、私はむしろ嬉しく思っています。
そして、Kaggle Masterまであと金メダル1つ。
70歳までに、AIを「相棒」にして金メダルに挑戦します。
試行錯誤を楽しみながら、AIとの協働でどこまで行けるのか、試してみたいと思います。

次のローカルLLM実験は DeepSeek-V4-Flash(284B MoE / 13B active)+FreeToken。
RTX 3090+3060(VRAM計36GB)で、どこまで実用的に動くか試してみます。
注目しているのは単純な生成速度(tok/s)だけではなく、むしろ次の2点。
① 回答・Coding Agentとしての品質
Qwen3.8-27Bと同等以上の仕事ができるか。
② タスク完了までの実時間
Qwen3.8では複雑なタスクでthinkingが数千tokenまで膨らみ、生成速度が速くても完了まで長時間かかるケースがありました。
DeepSeek-V4-Flashが仮に20~25 tok/s程度でも、無駄な長考が少なく、同等以上の品質で早く仕事を終えられるなら十分価値があります。
「何tok/s出るか」ではなく「良い仕事を何秒で終えられるか」を比較してみます。
#LocalLLM #DeepSeek #FreeToken #Qwen #RTX3090 #RTX3060
RTX 3090+RTX 3060(計36GB VRAM)でQwen3.8-27Bの検証。
最終的にLM StudioはContext 224Kで運用することにしました。
予想以上だったのはVRAM分散。3090+3060へ自動的に分散され、特に3060側をかなり積極的に使用。それでもレスポンスの大きな悪化は感じませんでした。
256Kも動作しましたがVRAMがほぼフルになるため、普段使いは224Kが良さそうです。
チャットはLM Studioでそのまま利用し、開発ではClaudeをマネージャ、Qwen3.8をローカルWorkerとして活用していく予定。
実コードの調査・修正・テストまで動かせたので、ここからは実務で使いながら評価します。
#LocalLLM #Qwen #LMStudio #RTX3090 #RTX3060
RTX 3090 24GB + RTX 3060 12GBの2枚構成で、Qwen3.8-27Bを試しています。
合計36GBのVRAMにうまく分散され、Context 256Kでも生成速度は約65 tok/s。3060側がPCIe x4なので速度低下を心配していましたが、体感上ほとんど気にならず快適です。
これは予想以上。次は長コンテキスト時の品質やCoding Agentとしての実用性を検証してみます。
RTX 3090 24GBでQwen3.8-27Bを検証中。
Unsloth GGUF / UD-Q4_K_S、LM Studioで、Context 80K + Think ON → 41.86 tok/s。回答も即開始。
No Thinkでも42.16 tok/sとほぼ同等。
88Kでも38.94 tok/s、92KではVRAM限界付近でPC操作まで重くなった。今のところ 80K + Think ONが常用候補。
RTX3090 24GBでQwen3.8-27Bを試していますが、次は余ったRTX3060 12GBも挿して、24GB+12GBの2GPU構成を実験してみたい。
特に長いコンテキストが24GBに収まらない場合、CPU RAMへoffloadするのと、3060のVRAMへ分散するのとで、レスポンス速度がどの程度違うのか。実用に耐えるのか試してみます。
RTX3090+Qwen3.8-27Bを一日試してみて、かなり手応えあり。
普通のチャットだけでなく、企画検討や研究設計のレビューもかなり高品質。Coding Agentは長考しすぎる課題もありますが、ローカルLLMの実用性をかなり感じました。明日も色々試します。
RTX3060にお別れし、RTX3090の中古に交換してみました。まずLM StudioでQwen3.5-35Bの動作を確認し、GPU offload後は約35 tok/s。
次はいよいよQwen3.8-27B(GGUF)のローカル実行を試します。まずは16GB程度の量子化モデルから。どこまで実用的に動くか楽しみです😀

Moving up to rank 113. rising like my electricity bill. #kaggle - kaggle.com/competitions/rogi…
Up to rank 128. Now accepting donations for more RAM. #kaggle - kaggle.com/competitions/rogi…
息子が会社で受けたTOEIC、975点(L満点)だった。もうどう頑張っても追いつけそうにありません。
TOEICは英語力だけでなく、「パターン認識や処理スピード」も重要と言われますが、T大卒の息子を見ていると、日本語・英語共通の「素早く正確に要点を掴む読解力」と、試験で求められる解き方を徹底的に身につける姿勢に差を感じます。その積み重ねが、試験での強さにつながっているのだと思います。
年末からの香港出向。実践英語を磨く最高の修行の場にしてほしい。
AIを使えば、プロトタイプは驚くほど短期間で作れるようになりました。
しかし、実際の仕事で難しいのは、その前にあります。
・現場の業務を理解する
・本当の課題を見極める
・どこまでAIに任せるかを決める
・どこを人間が判断するかを決める
・現場で使える形に落とし込む
コードを書く力だけでなく、業務を理解し、問いを立て、判断の境界を設計する力がますます重要になっていると感じます。
AI時代に経験が価値を持つのは、過去のやり方を知っているからではありません。
現場で何が起きるかを想像し、AIの答えを鵜呑みにせず、成果につながる形へ修正できるからだと思います。
あるメルマガで「FDE(Forward Deployed Engineer)」という働き方を知りました。
顧客の現場に入り、
・業務を理解する
・課題を発見する
・AIを活用した改善策を考える
・プロトタイプを作る
・現場への定着まで伴走する
単にシステムを作るだけでなく、成果が生まれるところまで一貫して関わるエンジニアです。
私自身、日々の仕事の中で、定型的な作業はどんどんAIが担ってくれるようになったと感じています。
そんな中で人間に求められるのは、
「何を作るか」だけでなく、
「何を解決すべきか」を考え、
AIを活用しながら、現場の人と一緒に成果を生み出すことではないでしょうか。
40年以上前、入社直後に上司から聞いた、技術者の在り方についての言葉を思い出しました。
「技術者とは、自ら課題を見つけ、その本質を見極め、解決し続ける人だ。その道はいばらの道。進むかどうかは自分で決めなさい」
当時は厳しい言葉だと思いました。
しかし、AI時代になった今、改めてその意味が分かります。
自ら課題を見つけ、その本質を見極め、AIを活用しながら、現場の人と一緒に、解決策を成果につなげていく。
FDEとは新しい職種のように見えて、実は昔から変わらない「エンジニアの本質」なのかもしれません。