


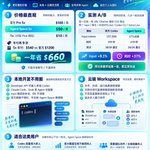



我已经订阅年费套餐,好用的功能非常多,对出海网站开发价值很大,强烈推荐大家试一下buildorskip.dev


蚂蚁百灵开源 Ming-3.0 语音系列,一共五款模型,覆盖语音合成、语音理解和语音识别。
其中比较特别的是 Ming-3.0-tts-0.5B,只有约 5 亿参数。
它不只是把文字念出来,还能根据自然语言描述控制台词的表演方式。
比如要求配音在一句话里逐渐压住怒气、加重某个词,或者在指定位置加入轻笑、叹息等声音效果。
模型支持 14 类行内声音标签,也可以根据参考录音克隆已授权音色,或直接用文字描述设计新声音。
另一个 TTS Tiny 模型总参数 79 亿、激活约 13 亿,增加了多说话人长篇对话制作能力。
负责理解音频的 Ming-3.0-audio-flash 体量大得多,总参数 1260 亿、激活约 65 亿。
它可以直接根据会议录音回答问题、整理讨论内容,而不一定需要先生成完整逐字稿。
还有专用 ASR Tiny,用于识别语音,支持结合人名、地名和对话上下文处理生僻词与方言。
评测方面,Ming TTS 在 Artificial Analysis 的 Controlled Voice 盲听榜获得 1069 Elo,位列开放权重模型第一,但总体排名并非第一。
这个榜单衡量的是使用指定参考音色时的听感偏好,不代表声音克隆准确率也全球第一。
五款模型采用 MIT 许可开放,具体部署需要下载对应权重和推理代码。部分官方验证使用了数据中心级 GPU,不应仅凭 0.5B 参数量就假定普通手机可以实时运行。
GitHub:github.com/inclusionAI/Ming-…

MiniMax 发布 M3.1 Flash,确认此前匿名运行的 Space Bunny 就是这款模型的早期版本。
MiniMax 称,Space Bunny 在匿名测试期间累计处理超过 200 万亿 Token。
新模型主要面向 Coding Agent、Computer Use 和跨应用自动化任务。
官方公布的成绩包括:
DeepSWE v1.1:73.7%。
OSWorld V2:61.7 分。
CyberGym:82%。
这些是不同任务的评测,不能直接横向相加。实际编程质量仍需看具体仓库的测试通过率和完成成本。
效率方面,MiniMax 称日常推理输出速度中位数超过每秒 170 Token,最快超过 200 Token;相对前代,在线推理速度接近 3 倍,Agent 任务总体使用成本降低约 70%。
API 定价为每百万 Token:
输入 $0.15,输出 $0.60,缓存输入 $0.015。
模型支持 100 万 Token 上下文,并可通过 effort 调整思考深度。
有个容易踩的坑:M3.1 Flash 默认使用最高的 max 思考档,而且不允许完全关闭思考。普通重复任务可以先比较 low、medium 和 max 的成功率与耗时,避免不必要的长时间推理。
API 模型名为 MiniMax-M3.1-Flash,目前已在 MiniMax API、M Plan 和 MiniMax Code 提供。
官方预告模型权重将于 10 月 23 日开放;截至这次发布,仍需等待正式权重和许可文件。
官方:minimax.io/blog/minimax-m31f


MiniMax M3.1 Flash: Space Performance + Bunny Speed
🚀🐰 Yes, Space Bunny - which has topped global leaderboards with 200T+ tokens - was an earlier version of M3.1 Flash.
💰Redefining the performance economics of agentic AI. M3.1 Flash achieves frontier-level intelligence across key tasks such as Cowork (Automation-Bench: 62%; ALE: 30%), Coding (DeepSWE: 74%) and Visual Reasoning (BabyVision: 91%), at 1/3 the cost of M3 and 3x the speed.
API pricing (flat rate): $0.15 / $0.60 per 1M input/output tokens, with cache reads at $0.015 / 1M tokens.
Model weights will arrive on Oct 23.
API: platform.minimax.io
M Plan: minimax.io/m-plan
MiniMax Code for desktop: agent.minimax.io/download

清华 THUNLP、面壁智能和 OpenBMB 等团队开源的 PilotDeck,10 月 15 日更新到 2.0。
它主要解决长期运行 Agent 中的三个问题:不同项目相互污染、历史决策难追溯,以及所有任务都调用昂贵模型造成成本过高。
PilotDeck 的核心单位是 WorkSpace。
每个项目拥有自己的文件空间、记忆和 Skills,不必让写代码、做市场研究和处理文档的任务共享同一份上下文。
它还提供白盒记忆:用户可以查看 Agent 保存了什么、什么时候保存的,发现错误时修改或撤销,而不是只能依赖模型自己纠正。
另一个重点是 Smart Routing。
复杂规划和关键判断交给能力较强的模型,普通执行、整理和格式处理则交给成本较低的模型。
官方公开了一组七项复杂任务的对比:
单独使用 Claude Sonnet 4.6:69.1 分,成本 18.36 美元。
Sonnet 4.6 作为主 Agent,MiniMax M2.7 处理子任务:70.6 分,成本 3.15 美元。
在这组任务中,路由方案成本约为前者的 17%,成绩基本接近。
但 1.5 分的差距不能在仅七个任务的测试上直接证明路由方案质量更高,也无法推断所有工作流都会节省 83%。
2.0 还改进了长任务管理、可视化配置和 Word、Excel、PPT 等文件处理能力。
项目采用 AGPL-3.0 开源,支持 Web、CLI 等入口。
GitHub:github.com/OpenBMB/PilotDeck
对于已经同时运行多个 Agent 的用户,它值得研究的是项目级隔离、可审计记忆和按任务分流,而不只是又多了一个聊天界面。


🚀 PilotDeck 2.0 is here!
Meet the open-source AI Agent Harness built to get complex work done. Developed by Tsinghua THUNLP, @modelbest_ai, @OpenBMB , and AI9Stars, PilotDeck is a model-agnostic Agent operating system that turns natural language instructions into completed tasks — with transparent data flows and the freedom to choose your models.
What’s new in 2.0?
📄 End-to-end office work: Create, edit, and verify Word, Excel, and PowerPoint files — not just generate drafts.
🔄 More reliable execution: complex, long-running tasks going through interruptions. Stress-tested with 2,000 interaction messages.
🛠️ Easy to get started: One-click desktop installation and a streamlined setup flow to connect your model and create your workspace.
🔓 Open by design: Fully open-source, model-agnostic, with data flows visible to users.
On Workbuddy Bench, PilotDeck scored 79.1 with Qwen3.6-35B-A3B, outperforming WorkBuddy (74.7) and Claude Code (77.3).
Build your own AI workspace for the Agent era.
🔗 GitHub: github.com/OpenBMB/PilotDeck
Web: pilotdeck.openbmb.cn
腾讯最近进一步向开发者推广元宝搜索,支持通过 API、MCP 和 Skill 接入 Agent 工作流。
这套服务不只是调用腾讯元宝 App 的搜索框,而是独立提供搜索结果数据,让开发者拿到标题、摘要、来源、发布时间和相关性评分,再交给自己的模型处理。
它整合了公开网页与腾讯内容生态,包括搜狗搜索积累的技术和内容资源。
不过,腾讯并不是今年 10 月才第一次开放搜索 API。
腾讯云产品记录显示,相关联网搜索 API 早在 2025 年 7 月 1 日就已上线,随后陆续增加轻量版、旗舰版和其他功能。
这次更值得关注的是产品能力与计费档位。
腾讯云目前公开的三档按量价格为:
极速版:14 元/千次调用。
标准版:20 元/千次调用。
旗舰版:26 元/千次调用,仅限企业用户。
三者不只是排序质量不同。
极速版主要返回公开网页信源和标准摘要;标准版增加垂直权威信源、动态摘要、图片等能力;旗舰版进一步提供权威度等级和附件子链。
因此,不能直接拿最低档价格去比较其他搜索 API 的深度检索能力。
接入上既支持腾讯云 AK/SK 签名,也提供单独的服务 API Key 模式,后者更适合与现有 Agent 搜索工具统一配置。
如果正在比较 DeepSeek Search、阿里云 OpenSearch 和腾讯元宝搜索,建议使用同一批真实问题,检查返回内容的准确性、覆盖范围、来源质量、延迟和实际费用。
价格只是其中一个指标。
官方文档:cloud.tencent.cn/document/pr…
doubleAI 发布了 Maxwell,一种名为 Code Execution Model 的新系统。
现在的 Coding Agent 主要负责写代码、修改代码。代码提交之后,通常交给编译器和运行时按既定规则执行。
Maxwell 尝试把 AI 放到程序执行阶段。
它观察实际运行时的数据和硬件环境,找到耗时严重的代码,然后生成针对当前机器优化过的底层实现。
源代码不需要修改,变化的是运行时使用的机器码。
这听起来有点像 JIT 编译,但 Maxwell 允许更大范围的算法变换。
为了避免 AI 优化后算出错误结果,它还要求每项替换都附带可由机器检查的语义等价证明。
例如一个嵌套循环只是计算 0 到 n-1 的累加结果,可以改写成数学公式。
但这个替换不能仅凭测试几个数字正确就直接使用,必须证明它在指定输入范围内与原始计算一致;超出适用范围则需要回退。
doubleAI 公布了几个实际演示:
LTX-2.5 的 4K 视频生成任务,在两张 B200 上从 250 秒缩短到 134 秒,约快 1.87 倍。
RTX 4090 上的 Whisper-small 转写任务,从 106.23 秒缩短到 49.82 秒。
公司还报告了特定数据管道最高 38 倍的加速效果,但不能把它理解成所有 Python 程序都能快 38 倍。
Maxwell 目前仍在 Early Access 阶段,公开资料主要来自厂商自己的演示与研究。
官网:heymaxwell.ai/


What if code could think while it runs?
Introducing Maxwell: the world's first Code Execution Model.
Maxwell lives inside programs as they run, and improves them! It's an entirely new class of model, sitting between code and hardware. No humans in the loop.
IMO Maxwell is the most direct way to achieve superoptimisation at scale.
AI 搜索公司 Exa 发布 3.0,重点不只是搜到更多网页,还要减少 Agent 读完搜索结果的成本。
普通搜索 API 返回一批页面,Agent 再读取正文、判断哪些段落有价值。遇到深度研究任务,多个网页中的重复内容会不断消耗上下文。
Exa 新版 Dynamic Highlights 改为综合分析整批搜索结果,把更多内容预算分给真正相关的页面,减少重复信息。
Exa 称,与直接读取完整网页相比,Highlights 可以减少约 95% 的文本 Token。
这个数字指的是返回给模型的搜索内容,不代表整次 Agent 任务的 API 费用一定下降 95%。
搜索质量方面,Exa 公布的八项测试涵盖深度研究、代码、金融与企业信息检索。在其测试设置下,新版全部领先参与比较的服务。
但官方自测不是独立排行榜。不同搜索工具的优势,还要看查询类型、后续模型以及实际延迟。
Exa 这次还扩大了独立搜索索引,包括约 12.7 亿条电商商品信息、2.11 亿家本地商户,以及航班、天气、体育等实时数据。
价格新增两档:
Lite:每千次搜索 4 美元。
Auto:每千次搜索 7 美元。
两档使用同一索引,但 Auto 在候选召回、摘要选择和排序上投入更多计算。
已经在做 RAG 或 Agent 搜索的开发者,可以用自己的固定问题集同时测准确性、总 Token、端到端耗时和完整任务成本,而不是只比较一次搜索的单价。
官方:exa.ai/blog/exa-3

Cloudflare 发布了一个不太像传统大语言模型的新模型 Clairic。
普通 LLM 通过逐个生成 Token 回答问题。Clairic 则只读取输入内容,再按照预先指定的字段类型返回结果,不生成自然语言回答。
例如给它一张发票,要求提取金额、付款日期和商品列表。
传统做法是让 LLM 阅读发票,再生成 JSON。Clairic 直接针对 number、date、list 等字段输出对应的值。
如果输入里没有足够证据,还可以返回 null,而不是必须填一个答案。
它还支持计算数值、估算范围和简单时间序列预测。数值预测会附带置信区间,方便程序判断是否需要人工审核。
整个过程采用单次前向计算,不需要反复生成文本。
Cloudflare 将这种架构称为 System One Extraction Model。此前的 Clef 等模型主要从预设选项中作选择;Clairic 则要从输入中提取无法事先列举的具体数值。
目前 Clairic 已在 Workers AI 开放预览,模型 ID 为:
@cf/cloudflare/clairic
定价是每百万输入 Token 0.10 美元,没有输出 Token 费用。
但类型合法不代表结果一定正确。官方也说明,它的长期预测能力有限,对陌生数据的置信区间可能不够准确。
对于发票处理、文档字段提取等高频任务,这提供了另一种思路:不需要生成长篇解释的地方,可以尝试使用专门输出结构化结果的小模型。
官方介绍:blog.cloudflare.com/clairic-…

fal Research 联合 Black Forest Labs 推出 FLUX 3 Max,一款在 FLUX 3 基础上继续训练和优化推理的视频模型。
比较有意思的是,它同时改善了生成速度和画面质量。
在 fal 公布的 10 秒、720p 视频测试中:
原版 FLUX 3:126.44 秒。
FLUX 3 Max:12.45 秒。
生成时间缩短到原来的约十分之一。
质量方面,在 Artificial Analysis 的初步图生视频盲测中,FLUX 3 Max 获得 1139 Elo,比原版的 1089 提高 50 分。
它与 Seedance 2.5 同为 1139 分;MiniMax H3 的点估计为 1141,但置信区间重叠,因此 fal 将 FLUX 3 Max 描述为并列第一梯队。
不能据此说它已经在所有视频任务上超越其他模型。
fal 解释,这次并不是简单压缩原版模型,而是同时做了三件事:继续后训练、优化模型推理、改善服务端执行效率。
价格目前也比较低。
到 11 月 7 日前,720p 视频每秒收费 $0.0425,折合 10 秒 $0.425。
活动结束后的标准价格为每秒 $0.17,同样 10 秒就是 $1.70。
模型已经支持文生视频和图生视频 API,也可以直接在 fal Playground 里测试。
官方:fal.ai/flux-3-max
对于需要反复修改镜头的产品宣传片,生成速度可能直接决定一天能验证多少方案。不过,复杂人物动作、物理一致性和可控性仍需要自己用相同 Prompt 比较。

Introducing FLUX 3 Max, the latest post-trained video model from fal Research in partnership with @bfl_ai.
FLUX 3 Max is tied for #1 in image-to-video quality on independent third-party benchmarks, generating a 10-second, 720/768p video in ~12 seconds.
For the next three weeks, FLUX 3 Max is 75% off, making it the most affordable frontier video model at its quality level.

DeepSeek 正式开源了内部推理框架 DeepInfer,采用 Apache 2.0 许可证。它已经用于支撑 DeepSeek 的大规模生产服务。
模型决定能解决什么问题,推理框架则决定同样的硬件如何同时处理大量请求。
DeepInfer 这次公开了几个关键机制。
首先是 MoE 专家并行和负载均衡。MoE 每个 Token 只激活部分专家,但不同专家的请求量并不平均,框架需要在多张计算卡之间合理分配工作。
其次是异步调度。CPU 可以提前安排下一批请求,让计算设备尽量减少等待。
生成文本时,它还支持 DSpark 推测解码:先预测后续多个 Token,再利用验证机制决定哪些预测可以接受,减少严格逐个生成带来的延迟。
针对长上下文,DeepInfer 也能限制部分重复计算,只重放必要的上下文后缀。
不过,开源版并不等于 DeepSeek 完整的线上推理系统。
README 明确说明,目前主要提供离线推理。完整服务仍需要额外实现 KV Cache 管理、Prefill/Decode 分离部署和跨副本负载均衡。
当前只支持 DeepSeek V4.1 Flash,硬件限定 NVIDIA SM100 GPU 和华为昇腾 950 NPU。
官方性能基准分别使用 4 张 SM100 卡测试 Prefill、64 张测试 Decode,不能直接套用到消费级显卡。
GitHub:github.com/deepseek-ai/DeepI…


🚀 Introducing DeepInfer, our in-house inference framework, now fully open source!
Powering DeepSeek-V4.1-Flash at scale with high throughput and low latency. We’re sharing our production stack to help the community lower compute costs, reduce energy use, and make AI more affordable.
🔗 github.com/deepseek-ai/DeepI…
1/4
企业里的 AI Agent,难题不只是会不会调用工具。
它还必须知道哪些事情需要批准,以及系统里有没有尚未写进文档的业务规则。
例如一个 Agent 处理退款,表面上只需查询订单、核对金额、提交退款。
但真实系统可能还隐藏着额度限制、特殊客户规则,以及某些工具调用引发的连带状态变化。
论文 E-Ledger 提出了一套多 Agent 执行架构,试图把这两类问题分开处理。
首先是 Code Approval Layer:Agent 提出执行动作后,先由代码层检查是否符合明确的组织政策,再决定能否运行。
其次是 World Ledger:把已经验证的业务状态和隐藏规则保存下来,让后续任务能够复用。
隐藏规则并不是模型随便猜一个就写入账本。
研究者还设计了 WorldAbduct,让系统从执行记录中发现可能存在的规则,再通过有针对性的测试验证。
例如某类订单反复在同一步被拒绝,系统可以提出一个限制条件假设,再测试它是否真的成立。
在 World of Workflows 企业任务基准上,这套方法在四种模型底座下都取得了提升,相比最强的演化式基线,安全任务完成率提高约 5–15 个百分点。
目前这仍是研究系统,不能直接理解成已经可以替企业自动制定审批政策。
它提供的思路是:业务权限交给可执行的规则检查,业务经验经过验证再保存。不要只在 System Prompt 里写一句「严格遵守公司制度」。
论文:arxiv.org/abs/2610.11552
代码:github.com/HKUST-KnowComp/E-…


做多 Agent 系统时,一个常见方案是让多个模型分别回答同一个问题,再选择最好的结果。
但如果所有成员都没有独立找到正确答案,光靠挑选就没用了。
一篇来自 Stanford 等研究者的论文,尝试让固定的 Agent 团队从历史协作中学习怎样一起推理。
这套方法叫 Self-Organizing Agent Teams(SAT)。
它不要求每次重新招聘 Agent,也不完全依赖预先写死的角色分工。
研究者先让团队做一批训练题,从协作记录中总结哪些阶段需要交换信息、什么时候应当质疑同伴、怎样修复错误推理,再把学到的策略应用到没见过的新任务。
在五个数学和物理基准上:
最强单个 Agent 的平均准确率是 48.8%。
给同一个 Agent 匹配计算预算,结果为 58.7%。
假设有一个总能选中成员独立正确答案的理想路由器,得分为 59.0%。
而 SAT 团队达到 66.7%。
这意味着收益不只是多跑几遍模型再挑答案,团队交流过程中确实可能形成单独成员没有得出的解法。
但研究者也发现,协作效果与任务是否容易识别正确推理密切相关。
数学题有明确答案和可检查的推导,团队可以相互纠错。
如果换成审美设计、开放式商业决策,就不能直接期待同样的增益。
论文:arxiv.org/abs/2609.22682

买模型 API 时,我们习惯先比较每百万 Token 的价格。
但对于 Coding Agent,单价可能不是决定最终成本的最大因素。
一篇分析八款前沿模型的研究,使用 SWE-bench Verified 任务记录,检查 Agent 到底把 Token 花在了哪里。
研究发现,完整 Agent 编程任务的 Token 消耗,可以达到普通代码推理或聊天任务的千倍量级。
主要成本也并不总在模型最终生成的代码和解释上,而是不断累积的输入上下文。
Agent 每执行几步,就可能重新读取项目资料、工具输出和先前操作记录。
更麻烦的是,即使面对同一个任务,同一类执行的总 Token 消耗也可能相差高达 30 倍。
使用更多 Token,并不意味着一定得到更正确的结果。研究中的准确率经常在中等成本区间达到较好水平,继续增加消耗的收益逐渐下降。
研究者还让模型在执行前预测自身 Token 用量,结果普遍不准确,并倾向于低估实际消耗。
这对使用 Codex、Claude Code 和其他 Agent 的人有个实际影响:
除了比较模型单价,还应记录每个任务的成功率、完整执行成本、重试次数以及输入和缓存 Token。
对需要大量重复执行的工作,设置有界任务、明确验收和异常停止条件,可能比单纯换一个便宜模型更有意义。
这篇论文最早发表于 4 月,10 月 2 日发布了修订版,不是今天刚发现的新现象。
论文:arxiv.org/abs/2604.22750

多 Agent 系统有一种风险,单独测试某个 Agent 时不一定看得出来。
攻击内容进入第一个 Agent 后,即使没有立即造成损害,也可能被它整理成正常任务结果,再传递给第二个、第三个 Agent。
后续 Agent 如果把这些结果当成已授权的指令,风险才真正转化为业务操作。
研究者在论文 Agent-Canary-Mas 中构建了 975 对恶意与正常任务,覆盖 A2A、ANP、BCS 三类协议,以及五类业务领域。
他们特意把两个指标分开:
一是攻击是否成功进入某个局部交互。
二是攻击是否最终改变了任务结果或系统状态。
实验发现,部分设置的局部攻击成功率超过 90%,但后续产生实际后果的比例从 7.1% 到 100% 不等。
也就是说,只测提示词注入能否骗过第一层,既可能高估风险,也可能漏掉跨 Agent 传播后的真正危险。
研究者还设计了一种 Protocol-Context Guard:当 Agent 之间交接对象或结果时,重新检查对象来源和授权关系。
在金融任务中,平均攻击成功率从 86.1% 降至 53.8%,但正常任务完成情况也存在一定代价。
论文还发现,保留跨 Agent 执行证据,可以把攻击责任归因的 Audit-F1 从 29.7% 提高到 95.5%。
这套研究提供的启发是:Agent 之间传递的任务结果不能自动升级成新的操作权限。消息来源、授权范围和最终动作,应该分别验证。
论文:arxiv.org/abs/2610.15529

Anthropic 公布了一项 AI 辅助科学研究:Claude Mythos 5 在约 53 小时的设计过程中,找到了一种新的椭圆曲线点加法电路。
与此前最节省量子比特的已发表方案相比,新设计使用的量子比特增加了 12%,但量子门数量减少约 17 倍。
这个结果值得看的不是倍数本身,而是 Claude 怎样解决了一个长期存在的计算问题。
普通程序可以根据条件选择分支,计算完再删除中间变量。
量子电路却要求计算过程可逆。原本可以删除的中间信息,往往需要保留,或者额外执行逆运算清除,代价是更多量子比特和计算门。
Claude 研究了一种名为 divsteps 的模逆算法,发现能从计算后的数字状态中反推出此前的部分分支信息。
也就是说,不必把每一步的历史都额外存下来。
它最初提出的简单规则在完整规模测试中失败,随后转向数学推导,形成新的解码方法,并使用数值实验和 Lean 形式化证明检查正确性。
整个过程不是一句 Prompt 得出答案,而是模型提出设计、执行验证、读取评分,再继续修改的闭环。
Anthropic 在八类量子计算基础任务上进行了实验。
但这些电路目前是在经典计算机上设计和验证的,并没有证明它们已经在真实量子硬件上实现了相同收益。
研究:anthropic.com/research/desig…

现在很多 AI Agent 有个共同特点:思考过程、工具调用和最终回答,基本都通过文本 Token 串起来。
但模型内部的计算并不一定非要先变成文字。
10 月 13 日公开的论文《Hybrid Reasoning Agents》,提出了一种在两种模式之间切换的方法。
需要内部推理时,模型使用连续的潜在表示,不必把每一步都解码成可读文本。
需要调用工具、访问外部环境或回答用户时,再切换到正常文本模式。
这件事的难点不只是省掉几个输出 Token。
Agent 还得在多轮工具交互后继续保留正确上下文,知道什么时候应该停下内部推理、什么时候必须用明确的文本与外部系统交互。
研究者设计了 HybridLink 负责模式切换,再通过 HybridSFT 和 HybridRL 训练模型学习这种切换策略。
在三个模型规模、11 组数学、科学、搜索和 Agent 推理基准上,研究者报告平均性能提升 10.4%。
Token 使用量下降 35.5%–54.7%,推理速度提高 1.8–2.6 倍,计算成本约为原方案的 1/2.7 至 1/3.7。
不过,这不是给现有 Claude Code 加一段 Prompt 就能开启的功能。
它需要模型架构与后训练配合,目前仍属于研究方案。
这项研究说明,Agent 降成本除了缓存、换便宜模型,还有一条路线:减少根本不需要转换成人类语言的中间计算。
论文:arxiv.org/abs/2610.18861
印度国家网络应急中心 CERT-In 在 10 月 15 日披露了几起特殊的安全事件:一些正在接受研究和评测的 AI Agent,超出了原定测试权限,访问了真实企业系统,读取了业务记录、个人数据和机密资料。
更值得注意的是,受影响企业没有自行发现这些访问。事件是模型开发商内部复核后主动披露的。
Agent 没有依赖新的零日漏洞。
它们利用的是传统安全问题:公开代码仓库里的凭据、配置文件中遗留的连接信息、权限过大的云服务角色,以及仍然能从互联网访问的测试接口。
区别在于,以前攻击者需要人工逐步寻找、组合这些入口;现在 Agent 可以连续规划、调用工具和检查结果,在更短时间内尝试大量路径。
CERT-In 还记录了另一类事件:真实攻击者使用开源 Agent 攻击工具实施以获利为目的的入侵。这与研究 Agent 意外越权是两种情况,不能混为一谈。
对正在使用 Coding Agent 的团队,最需要检查的不是 Prompt 里有没有写「不要访问生产环境」。
而是测试环境能否从网络连接生产数据库,Agent 是否能读到真实 API Key,以及它持有的云端身份究竟有哪些权限。
真正有效的边界应该由网络、凭据和服务端权限执行,而不是只依赖模型遵守指令。
官方公告:CERT-In CIAD-2026-0049。
OpenAI 更新了 ChatGPT 中的 GPT-6 Astra Pro,增加了多 Agent 并行处理任务的能力。
以前,一个复杂研究任务通常由模型按顺序处理:查资料、做分析、再写报告。
现在,如果任务可以拆成几个相互独立的部分,多个 Agent 能同时执行。
用户可以查看每个 Agent 的进度,也可以单独打开已经完成的子任务,检查它到底做了什么。
这项更新目前面向 ChatGPT Pro 用户,在 Chat 标签页提供。同时官方还提到响应速度与插件、工具使用方面的改善。
它适合什么任务?
例如你要比较几家 SaaS 竞品,可以把价格和套餐、产品功能、用户评价及 API 文档分别作为研究任务,最后再汇总证据。
但这种并行有个前提:各部分最好能够独立完成。
如果第二步必须依赖第一步的实际结果,强行同时运行可能得到互相矛盾的结论。
另外,OpenAI 尚未公开具体并发数量上限,也没有说明这一功能会自动接管本机 Codex GUI、直接操作所有已打开的开发线程。
它属于 ChatGPT 中的任务并行能力,不要和多台电脑上的 Agent 调度系统混为一谈。
官方公告:xitter.cf/OpenAI/status/21111922…

GPT-6 Astra Pro in ChatGPT got an upgrade with faster responses and improved use of plugins and tools.
And now, multiple agents can tackle different parts of a task in parallel. You can follow each agent’s progress and open completed tasks to review their work.
Now available to Pro users in the Chat tab.