
فعال در مهندسی نرمافزار با اندکی تجربه از صنعت (عمدتا گوگل) و آکادمی (عمدتا اتلاف عمر). علاقمندم آموختههامون رو رد و بدل کنیم. [email protected]
Joined September 2020
- Tweets2.5K
- Following13
- Followers8.2K
- Likes2.1K



Pinned Tweet
ما یک گوشهای بساط کردیم تا از هم چیز یاد بگیریم. ولی خوب اینجا توییتره و برخی دوستان هم دنبال حاشیه و به هم زدن این بساطن، نه تبادل تجربه.
۱. گروهی از دوستان نهایتا بلاک شدن. اولا اگر هر بلاکی به اشتباه رخ داده، من عذر میخوام و لطفا بفرمایید اصلاح بشه؛ ایمیل در بیو هست.👇
با پیگیریهای بچههای انجمن علمی، همه وجههای باقی مانده به موسسه خیریه حمایت از کودکان مبتلا به سرطان محک تقدیم شد


اطلاعیه شماره ۲ انجمن علمی کامپیوتر شریف درباره بازگشت وجه کارگاه
به اطلاع میرسانیم وجه پرداختی ثبتنامکنندگانی که تا تاریخ یک اسفندماه ۱۴۰۴ فرم پست قبلی را تکمیل کرده بودند، در روز چهارشنبه، ۲۰ خردادماه و پس از کشوقوسهای اداری به حسابهای بانکی اعلامشده واریز شده است.
اگر هنوز اقدام به تکمیل این فرم نکردهاید، از طریق لینک زیر میتوانید اطلاعات حساب خود را برای بازگشت وجه با ما به اشتراک بگذارید و یا در صورت تمایل به اهدای وجه واریزی به خیریه و صرفنظر از بازگشت آن، به ما اطلاع دهید.
لطفاً در هر دو صورت، تا پایان روز دوشنبه، ۱۵ تیرماه این فرم را تکمیل کنید. در غیر این صورت، وجه پرداختی به خیریه اهدا خواهد شد.
فرم بازگشت وجه: docs.google.com/forms/d/e/1F…

در این گفتگوی شنیدنی پادکست طبقه ۱۶ با سعید محمدی، همبنیانگذار دیجیکالا بزرگترین e-commerce ایران، ارجاعی هم شد به گفتگویی که من پیشتر سعی کرده بودم در این پادکست باز کنم. خیلی خوشحالم که این گفتگوها به لایههای تصمیمگیر میرسه، ولی همونقدر هم ناراحتم که اشتباه میرسه.
گفتگویی که بهش ارجاع داده میشه (چند قسمت پیشتر در همین پادکست) درباره نگاههای کوتاهمدت و بازاریمحور در بین مدیر عاملهای بازار فناوری ایران بود، ولی بازبَیانی که اینجا میبینیم ازش میشه، همون حرفهای تکراریه که «تِکیها وسواس فنی دارن / فقط جنبه تکنیکال رو میبینن نه بیزینس رو». این تفکر در مدیران بیزینسی، در کل تفکر نابجایی نیست و از کارها و قضاوتهای غلطِ خود بچههای فنی و عشق ایدهآلگرایی و بیشمهندسی شکل گرفته، ولی اینجا نامربوطه چون حرف اصلا این نبوده.
چرا این موضوع برای من مهمه و دارم بهش واکنش نشون میدم و دربارهش مینویسم؟ چون دیجیکالا، فخر ایرانه. تپسی، دیوار، فیلان، همهشون فخر ایرانن. باید روز به روز بهتر هم بشن. ولی مثلا در همین دیجیکالا، به قول متواتر (!) از رهبران ارشد فنی خودشون، فیچری که پارسال در ۲ هفته زده میشده الان تو ۲ ماه و سال دیگه در ۶ ماه هم نمیرسه. شبیه همین مساله در شرکتهای دیگر هم هست. اینا چهطوری قراره حل بشن؟ اگر دعوایی بین طرفداران «حل این معضل» و طرفداران «این فیچرو بزن بیزینسم رو گازه» هست، این دعوای بین «نگاه فنی» و «نگاه بیزینسی» نیست (برخلاف برداشت نادرستی که به طرز ناراحتکنندهای در ویدیوی زیر میشنویم)، بلکه دعوای بین «نگاه بیزینسی بلندمدت» و «نگاه بیزینسی کوتاه مدت»ئه.
تازه اصلا از این مساله (تعالی فنی برای بقاپذیری خودِ بیزینس) که بگذریم، بخش دیگر و مهمتر حرفها در پادکست قبلی، «تعالی محصول» بوده.
آقای الف میگه اگر با ارائه featureهای بیشتر روی محصول تفمال میشه پول بیشتر درآورد، چرا من سراغ متعالیتر کردنِ محصولم برم؟ من تعالی محصول رو میخوام ولی فقط در جهت بیزینسم. آقای ب میگه من نمیخوام صرفا پول دربیارم، بلکه میخوام از یک محصول متعالی پول دربیارم؛ میخوام به چیزی که ارائه میکنم افتخار کنم.
آسیبشناسی من (یعنی همون گلایه و نق من) این بوده و هست که تقریبا همه مدیران شرکتهای فناور بازار ایران، آقای الف هستن. به شخص آقای الف هم هیچ ایرادی نیست، میگه من بیزینس زدم که پول دربیارم؛ دمت هم گرم که برای N نفر شغل ایجاد کردی. ولی به «اکوسیستم» ایراد هست که چرا همه آقای الف هستن و ب تقریبا نیست.
متوجه فشار و شرایط و نبودنِ فرصت برای این قرتیبازیها و و و هم هستم، ولی صحبت این حرفها نیست. به عینه دیدم. فرصتش بوده، تفکرش نبوده. دیگه دو ساعت حرف که پیشتر زدم رو اینجا تکرار نمیکنم. اگر با دو ساعت حرف زدن نتونستم منتقل کنم، حالا چه ایراد سمت فرستنده چه گیرنده، با یک صفحه یادداشت هم نخواهم تونست.
پ.ن. با تشکر از سهیل و سعید برای این گفتگوی شنیدنی.

خب، رسیدیم به اپیزود ۲۰۰
بعد از پادکست با مدیر ارشد مارکتینگ و مدیرعامل دیجیکالا، نوبت میرسه به خالق، بنیانگذار و رئیس هیئتمدیره گروه دیجیکالا. سعید محمدی
یه گفتگوی ۳ ساعته که امدوارم حالش رو ببرین
youtu.be/fmrKJClqUrY?si=HCuV…
چند تجربه از مقایسه Claude Code و OpenAI Codex
۱. قرار بود یک codebase نسبتا بزرگ (+۵۰۰ هزار خط کد) و ناتمیز رو LLM friendly کنیم (که خودش کار نابدیهیایه ولی موضوع امروز نیست). با مقدار خوبی اطلاعات پسزمینه شامل ۴۰-۳۰ صفحه شرح محصول و harnessهایی برای باز کردن و نکردن فایلها در context و غیره، از هر دو agent یعنی Claude و Codex جداگانه و با prompt و مستندات اولیه یکسانی خواستم که یک کار یکسان رو بکنن: هم در طراحی «چگونه codebaseمان را LLM friendly کنیم» کمک کنن (یعنی چهجور مستندها/استانداردها/ابزارها/CI gateهایی داشته باشیم) و هم برنامهای بدن برای کدخوانی بخش بخش و مستندسازی codebase طبق اون طراحی - که نهایتا شد یک برنامه شامل ۲۰~ مرحله مفصل.
سپس هر دو خروجی Claude و Codex رو دادم به خود Claude و Codex و به عنوان دو راه حل ناشناس، گفتم فلان مساله رو دارم و این دو راه حل رو: بسنجیدشون. اختلاف فاحشی گزارش کردن. Codex معتقد بود نتیجه کار Claude با اختلاف بهتره و کلا نتیجه کار Codex رو بذار کنار. Claude هم همداستان بود که خروجی Claude خیلی بهتره ولی گفت حالا خروجی Codex یه چیزایی داره که خوبه قبل از دور ریختن، اضافهشون کنی به خروجی. البته «LLM به عنوان داور»ها به پارامترهایی مثل طول و جزییات بیشتر سوگیری دارن، ولی تلاش کرده بودم بهشون بفهمونم با معیارهای مشخصی مقایسه کنن مانند این که کدوم plan اگر اجرا بشه به خروجی X-طورتر و Y-طورتری منتهی میشه. (طبیعتا «پیشبینی خروجی plan» یه چیزه و خروجی واقعی plan اگر اجرا بشه، یه چیز دیگه، که دومی رو نسنجیدم)
۲. میخواستیم یک سند نیازمندیهای محصولی (PRD) و طراحی فنی (design doc) بزرگ، هر یک ۱۰۰~ صفحه رو، پیادهسازی کنیم (برای یک web application با سطح محصولی گسترده). از هر دوی Claude و Codex خواستم که یک برنامه پیادهسازی بدن که بدم به AI بزنه. این هم شد یک برنامه +۲۰ مرحلهای مبسوط.
سپس خروجی هر دو رو دادم به خود Claude و Codex به عنوان دو راه حل ناشناس برای سند محصولی و فنی موجود، و خواستم برام بسنجندشون. باز هم پیشبینی هر دو این بود که اجرای planای که Claude داده، با اختلاف منجر به خروجی درستتری میشه.
۳. میخواستیم یک شرح محصولی نه چندان بزرگ رو پیادهسازی کنیم (برای یک سیستم شبیه pub/sub). بدون قرتیبازیهای «plan بده» و فلان، زرتی دادمشون به ۵تا LLM مختلف و گفتم کدش رو بزنید: Grok، Gemini، Composer، Sonnet، Codex. اون موقع (پارسال) نسخه Codexای رو با agent خود Codex و بقیه رو با Cursor agent زدم؛ با جدیدترین نسخه هر یک از مدلها. هر پنجتا، کد تقریبا یکسانی زدن، هم ظاهری و هم در پوشش caseها، طوری که من شک کردم نکنه اشتباه فایلها رو save کردم.
قطعا با ۳ تا حکایت/anecdote نباید نتیجهگیری کلی کرد (و شما هم نکنید) ولی نتیجه «فعلی» برای خودم که بر اساسش تصمیم میگیرم اینه که برای طراحی و planning کارهای کلان و/یا فهمیدن و سوار شدن روی یک codebase بزرگ، از Claude استفاده میکنم (منظورم فقط مدل نیست بلکه مشخصا agentاش)؛ برای taskهای کدزنی یا پیادهسازی یک طراحی فنی/محصولی ساده از بیخ روی یک صفحه سفید، agent کمتر مهمه و مدلها هم تفاوت محسوسی نمیکنن.
علاقمندم از تجربههای شما هم بشنوم.
پ.ن. میخواستم صرفا درباره agentها و مدلها یک تجربهای رو به اشتراک بذارم ولی برای این که احیانا برداشت اشتباه نشه این توضیح رو هم اضافه کنم که با همین Claude agent روی دو codebase مختلف، یکی تمیز و دارای راهنماها و harnessهای تکامل یافته و یکی فاقد اینها، خروجی کاملا مختلف و اصلا در دو سطح غیرقابل مقایسه میگیرم (یکی عالی و یکی افتضاح). این امر روز به روز واضحتر شده و دیگه نیسان آبی است که مهمتر از agent/مدل، harnessها/چارچوبهایی که براشون فراهم میکنیم هستن؛ یادداشت بالا مربوط به مرحله بعد و هنگام انتخاب agent/مدل پس از فراهم کردن اون زیرساختها است.
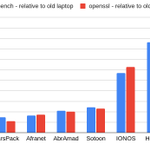
توان پردازشی CPUهای cloud providerهای ایرانی که من تست کردم، حتی high endهاشون، با اختلاف از cloudهای خارجی، حتی cheapهاشون، کمتره. من برای یک کاری نیاز به راهاندازی یک cluster داشتم و باید provider انتخاب میکردم، و رفتم چندتا رو تست کردم. از دو روش benchmark مختلف هم استفاده کردم که نتایج مختص به یک benchmark خاص نباشه و بشه تا حدی تعمیم داد: یکی دستور sysbench cpu run و دیگری دستور openssl speed sha256 روی VPSهای لینوکسی.
نتایج رو در عکسِ پیوست میبینید. برای هر ماشین دو عدد داریم که توان یک هسته رو نشون میده. چون خود اعداد خام معنی خاصی ندارن اونها رو با عددِ ماشین اول normalize کردم؛ بیش از ۱ یعنی قویتر و کمتر از ۱ یعنی ضعیفتر از ماشین اول (یک لپتاپ خیلی قدیمی ۱۳ ساله). benchmark مشخصا برای تک-cpu است و تعداد هسته ماشین، بلامحله.
تستها رو چند بار تکرار کردم و از صاحبان چندتا از این providerها هم پرس و جوهایی کردم. مشکل overcommit وجود نداشته. مشکل محتمل، ضعیفتر بودن و مشخصا قدیمی بودن cpuهاست. قدیمی یعنی مثلا برای ۶-۷ سال پیش.
اما نتیجه فرعی و شاید آوردهدارتر: شرکتهای فناوری زیادی مصرف پردازشی نابدیهی (بیش از ۱۰۰۰ هسته cpu؛ بالای ۱ میلیارد تومن در ماه) دارن و به دنبال کاهش هزینهش هستن، ولی همیشه صحبت از «تعداد هسته» و «قیمت هسته» است ولی «توان هسته» یک نکته فرعی و کیفی (نه کمّی) محسوب میشه؛ یا دیدهم که GHz هسته معیار توان گرفته میشه که نادرسته.
گوگل یک معیاری برای خودش تعریف کرده بود، GCU (مخفف Google Compute Unit). در سرورهای مدل فلان، هر ۱ هسته CPU معادل ۱/۸ GCU بود و در مدل دیگه، مثلا ۲/۵ GCU. دیگه به جای این که بگیم فلان تعداد CPU core هزینه یا صرفهجویی میکنیم، میگفتیم فلان تعداد GCU.
پیشنهاد من هم به دوستانی که در پی اندازهگیری و صرفهجویی در هزینه منابع سختافزاری به ویژه هسته CPU هستن، تعریف یک واحد «پردازش به ازای تومن» است - مثل GCU. مثلا وقتی داریم provider انتخاب میکنیم، فرض کنید برای استقرار سرویسمون و حفظ کیفیت و latency و فلانش، روی مثلا ستون به ۱۰۰۰ هسته نیاز داریم و روی افرانت به ۱۳۰۰ هسته ولی از طرفی قیمت ستون دو برابر افرانته و ادامه ماجرا ... (عددها فرضی هستن)
پ.ن. ضرب و تقسیمهای سادهسازیشده صرفا برای مثال هستن. متوجه تفاوت workload و غیره هستم. نکته، نیاز به کمّیسازی پارامتر توان پردازشی (برای workload خودمان) و رفتن از «قیمت هر core» به سمت «قیمت هر واحد توان پردازشی» است.

بالاخره بعد از دو سال تنگ کردم و قراره این کارگاه رو دوباره برگزار کنیم، این بار قراره تجربیات پیادهسازی خیلی از این حرفها در همین بازار ایران رو هم کنارش بیاریم. با تشکر از همت بچههای شورای علمی دانشکده کامپیوتر شریف (SSC).
```
عنوان: چرخه حیات توسعه یک سرویس نرمافزاری در کلاس جهانی
The Development Lifecycle of a World Class Software Service
چهارشنبه ۱۷ دیماه ساعت ۱۶، آمفیتئاتر مرکزی دانشگاه شریف. شرکت به هر دو شکل حضوری و مجازی ممکن است.
ثبت نام: ssc.ce.sharif.edu/se_worksho…
چکیده:
- چهطور سرویسهای معروف جهانی، مثلا google.com، همیشه بالا هستند و درست کار میکنند؟
- چهطور این حجم از تغییرات توسط هزاران توسعهدهنده به طور هرروزه روی چنین سیستمی انجام میشوند، بدون downtime یا bug بزرگ؟
- چهطور این همه توسعه میتواند روی همان بسترِ ۱۵ سال پیش انجام شود و همچنان کار کند؟
(طبیعتا ادعاهای بالا «نسبتا» است و نه «مطلقا»)
در این کارگاه یک نگاه اجمالی خواهیم داشت به سر تا تهِ چرخه تولید و استقرار و نگهداری یک سرویس نرمافزاری در کلاس جهانی: زنجیرهای از حلقههای فنی و فرهنگی از پیش از کدنویسی تا نوشتن و مدیریت و نگهداری خود کدها و سپس تست و release و monitoring و oncall و کشف و پاسخ به حادثهها و یاد گرفتن از آنها.
چه کسانی میتوانند از مطالب این کارگاه بهره ببرند؟
- مدیران و مهندسان ارشد نرمافزار (و زیرشاخهها؛ data و devops و غیره): مخاطب اصلی - بهره از همه مطالب.
- دانشجویان/مهندسان تازهکار: برخی مطالب ملموس و برخی از جنس «آشنایی برای آینده» خواهند بود.
- افراد غیرفنی: بیشتر مطالب ناملموس خواهند بود. اگر در صنعت فناوری مشغول هستید، ممکن است آشنایی با رویهها برای فهم و تعامل بهتر با تیمهای فنی سودمند باشد.
سوابق ارائه دهنده. مهندسی کامپیوتر نرمافزار دانشگاه شریف، دکترای مهندسی کامپیوتر دانشگاه تورنتو، مهندس staff نرمافزار و مدیر فنی در سیستم نمایش تبلیغات گوگل، راهبر ارشد فنی (CTO) یکتانت و مشاور CTO دیجیکالا.
تمامی مبالغ گردآوری شده، پس از کسر هزینههای برگزاری، به خیریه اهدا خواهند شد. در هنگام ثبت نام، مبلغ ثبت نام به انتخاب کاربر است و با توجه به روح خیریهایِ رویداد، توصیه میشود با مبلغی بیش از کفِ حداقلی ثبت نام نمایید.
```


اطلاعیه شماره ۲ انجمن علمی کامپیوتر شریف درباره بازگشت وجه کارگاه
به اطلاع میرسانیم وجه پرداختی ثبتنامکنندگانی که تا تاریخ یک اسفندماه ۱۴۰۴ فرم پست قبلی را تکمیل کرده بودند، در روز چهارشنبه، ۲۰ خردادماه و پس از کشوقوسهای اداری به حسابهای بانکی اعلامشده واریز شده است.
اگر هنوز اقدام به تکمیل این فرم نکردهاید، از طریق لینک زیر میتوانید اطلاعات حساب خود را برای بازگشت وجه با ما به اشتراک بگذارید و یا در صورت تمایل به اهدای وجه واریزی به خیریه و صرفنظر از بازگشت آن، به ما اطلاع دهید.
لطفاً در هر دو صورت، تا پایان روز دوشنبه، ۱۵ تیرماه این فرم را تکمیل کنید. در غیر این صورت، وجه پرداختی به خیریه اهدا خواهد شد.
فرم بازگشت وجه: docs.google.com/forms/d/e/1F…
اطلاعیه شماره ۲ انجمن علمی کامپیوتر شریف درباره بازگشت وجه کارگاه
به اطلاع میرسانیم وجه پرداختی ثبتنامکنندگانی که تا تاریخ یک اسفندماه ۱۴۰۴ فرم پست قبلی را تکمیل کرده بودند، در روز چهارشنبه، ۲۰ خردادماه و پس از کشوقوسهای اداری به حسابهای بانکی اعلامشده واریز شده است.
اگر هنوز اقدام به تکمیل این فرم نکردهاید، از طریق لینک زیر میتوانید اطلاعات حساب خود را برای بازگشت وجه با ما به اشتراک بگذارید و یا در صورت تمایل به اهدای وجه واریزی به خیریه و صرفنظر از بازگشت آن، به ما اطلاع دهید.
لطفاً در هر دو صورت، تا پایان روز دوشنبه، ۱۵ تیرماه این فرم را تکمیل کنید. در غیر این صورت، وجه پرداختی به خیریه اهدا خواهد شد.
فرم بازگشت وجه: docs.google.com/forms/d/e/1F…

Kian retweeted

مردم در اینکه جنگ بشود یا نشود هیچ عاملیتی ندارند. فعالان سیاسی و مدنی هم ندارند. تنها کشور حملهکننده است که با محاسبات خود به این نتیجه میرسد یا نمیرسد. موضعگیری هرکدام از ما در این زمینه به نظرم حتی ارزش اخلاقی هم ندارد. یعنی در نقطهای هستیم که واقعا اخلاق هم در این مورد جواب درستی ندارد؛ نگرانی برای اینکه مبادا جمهوری اسلامی امتداد یابد همان قدر اخلاقیست که نگرانی برای ویرانی و کشتار مردم در جنگ. ایران در وضعیتیاست که از تمام این معیارهای نسبی اخلاقی گذشته است.
پس یکدیگر را بر سر این موضوع سرزنش نکنید.

در مصاحبه اخیر با طبقه ۱۶ از مسالههای مختلفی حرف زدیم ولی مهمترینش برای خودم همینی بود که در این کلیپ بریده شده:
تفاوت ذهنیت بازاریمحور و کوتاهمدت به شکل «محصول رو با جهت بوی پول جهت بده» و ذهنیت محصولمحور و بلندمدت به شکل «محصول متعالی بساز و بیزینس رو پشتش بیار» - و این که دومی در اینجا در بازار فناوری ایران خیلی جاش خالیه.
در اونور هم کمه، ولی در اینور خیلی کمتر و تقریبا نایاب، حتی در جاهایی که سودده هستن و اینطور نیست که بگیم محبورن برای بقا بجنگن.
طبیعتا منظور با یک جمله منتقل نمیشه و پیشنهاد میکنم گفتگوی کامل رو ببینید و بعد خوشحال میشم دربارهش صحبت کنیم: youtube.com/watch?v=a4lriEKy….

قسمتی از اپیزود ۱۹۴ پادکست طبقه ۱۶ با کیانوش مختاریان
تماشای کامل در یوتیوب و همه اپلیکیشنهای پخش پادکست
youtu.be/a4lriEKyTjc
Kian retweeted

قسمتی از اپیزود ۱۹۴ پادکست طبقه ۱۶ با کیانوش مختاریان
تماشای کامل در یوتیوب و همه اپلیکیشنهای پخش پادکست
youtu.be/a4lriEKyTjc
Kian retweeted
EP 194 - Kianoosh Mokhtarian
بعد از گذشت حدود یه سال، دوباره نشستم با کیانوش مختاریان گپ زدم. کیانوش سالها بهعنوان مهندس ارشد تو گوگل کار کرده و از نزدیک با توسعهی سیستمهای بزرگ و فضای واقعی مهندسی نرمافزار تو مقیاس جهانی درگیر بوده. تجربههایی که از اون دوران داره، هم فنیه هم کاملاً کاربردی و از دل کار واقعی اومده.
youtu.be/a4lriEKyTjc
یکی از دوستان به تازگی بعد از ۱۵ سال برگشتن ایران پیش خانواده. چندان شبکهای در بازار کار ایران نداره و برای وصل شدنش به بازار کار اگر لینکی یا سرنخی دارید، لطف میکنید اگر راهنمایی کنید.
پروفایل ایشون: مهندس صنایع، فوق لیسانس مدیریت از دانشگاه اتاوا و ۱۲ سال سابقه کار در کانادا در زمینههای توسعه بازار بینالملل، فروش ماشینآلات صنعتی، ومدیریت پروژه در شرکتای بزرگ بینالمللی. تخصص: گسترش بازار و رشد فروش جهانی، مدیریت پروژههای چندمیلیوندلاری، و تجربه زیادی در ارتباط با مشتری و تیمهای چند ملیتی.
الان دنبال یه جایگاهیه که بتونه تجربهشو تو جاهایی مثل شرکتهای صادرات/واردات، تامین کنندههای تجهیزات/محصولات/ماشینالات، صنایع یا مجموعههایی که بیزینس بینالمللی دارن به کار بگیره.
اگه فرصت مناسبی سراغ دارید یا کسی رو در چنین صنایعی میشناسید که باهاش گفتگو کنه، خیلی ممنون میشم معرفی کنید. اگر ریتوییت کنید به آدمِ مرتبطش برسه هم لطف کردید.
بازخورد: در نقشه مسیریاب من همیشه از حالت نقشه دو بعدی به شکل شمال-در-بالا استفاده میکنم، که این قابلیت نه در نشان و نه در بلد درست پشتیبانی نشده و با تجربه کاربری نقشه گوگل فاصله داره. بلد رو مطمئن نیستم در فاز توسعه هستن یا نه ولی نشانیها که هستن بد نیست یک بازبینی بکنن.
This Post is from a suspended account. Learn more
در این گفتگوی ساده و صریح، درباره مدل کاری در شرکتهای فناوری/tech اینجا با نگاهی مقایسهای گپ زدیم، و من از چالشهایی که اینجا بهشون برخوردم یا ایجاد کردم، صحبت کردم.
من و پیمان مسیر عکس همدیگه رو رفتیم: من در مدل کاری اونور بزرگ شدم و بعد اومدم ایران، و پیمان برعکس، از اینور به اونور، و تفاوتها فرهنگی که تجربه کردیم اشتراکات زیادی دارن. کنار هم بحث شدن این دو جفت تجربه به نظرم محتوای آموزندهای رو فراهم کرده. پیمان اینجا همبنیانگذار و CTO یکتانت و مدتی مشاور CTO دیجیکالا بوده. من هم CTO یکتانت و مشاور CTO دیجیکالا.
این گفتگو در روزهای آخر من در یکتانت و در اردیبهشت (قبل جنگ ۱۲ روزه) ضبط شده.
یوتیوب: youtube.com/watch?v=cuPRGIxj…
اپهای پادگیر: پادکست «گپ با پیمان فخاریان» رو بجویید.

این اصطلاح معروف «همه چیز به شکل کد» (everything as code) رو حتما شنیدید. این رویکرد، خیلی خیلی خوبه. البته یک تله مهم هم داره. اول یک مرور کوتاه کنیم مساله رو، بعد ببینیم تلهش چیه، شاید یک سر کوچولو هم به دیجیکالا زدیم وسطش.
همه چیز به شکل کد یعنی مثلا وقتی شما:
- میخواید گروهها و سطحهای دسترسی در فلان سیستم رو تعریف کنید،
- میخواید داشبوردهای سیستم monitoring یا BI رو تعریف کنید،
- میخواید bucketهای object storageتون رو تعریف کنید،
- میخواید آزمایشهای سیستم A/B testing رو تعریف یا عوض کنید،
- و و و ...
نمیرید در پنل هر یک از سیستمهای مربوطه تا تنظیمات رو انجام بدید. بلکه تعریفها و تنظیمات رو به شکل یک json یا protocol buffer یا غیره مینویسید و در codebase نگه میدارید. سپس برای سیستمها و ابزارهای اولشخص (first party، یعنی کدش مال شماست؛ مثلا زیرساخت A/B testingای که خودتون توسعه دادید) به سادگی میگید تنظیماتش رو از codebase بخونه، نه این که پنل/UI خودش رو (مثلا برای تعریف A/B testها) داشته باشه. برای سیستمهای سومشخص (third party؛ مثلا سرویس object storageتون)، یک ابزار ساده مینویسید که این تنظیمات رو از مخزن کد بخونه و به سیستم مربوطه بفهمونه. برای بیشتر سیستمها، شدنیه.
ما مثلا حتی چرخهی oncallمون رو هم—یعنی این که چه کسانی در چرخهی oncall هستن، ایمیل و تلفن هر کدوم چیه، کِی تا کِی نوبت چه کسیه، اگه یکی جواب نداد چه کسی page بشه—به شکل کد در codebase تعریف میکردیم و نه مثلا در پنل سیستم alert manager.
چرا؟ چون همه تعریفها و تنظیمات در یکجا جمع بشه؟ نه، این آوردهی فرعیشه. آوردهی اصلی اینه که تغییرات، مثلا تغییر یک سطح دسترسی، مانند کدها از چرخهی code review رد میشه و یک جفت چشم دیگه هم میبیندش؛ از چرخه تست و CI رد میشه؛ log میشه و قابل حسابرسی/auditئه؛ قابل rollbackئه. وقتی همه چیز در codebase باشه، میتونید در سیستم CI تستهایی بنویسید که اصلا از بیخ جلوی push شدن یک تغییرِ نامعتبر (مثلا یک config بد) رو بگیره، یا برای تغییرات مهم، تاییدیههای اضافه بخواد قبل از این که اجازهی push بده.
مثال: فرض کنید میخواید تعریف یک A/B test رو عوض کنید، مثلا میخواید فلان پارامتر سیستم رو از الف بکنید ب و اثرش رو روی ۵٪ از ترافیک آزمایش کنید، یا میخواید درصد ترافیک فلان آزمایش رو از ۵٪ بکنید ۵۰٪. یک مهندس به تنهایی نباید اجازه چنین کاری رو داشته باشه. نه برای این که آدمها ممکنه بدسرشت باشن (!) بلکه برای این که اولا همهمون اشتباه میکنیم و اشتباه بخشی طبیعی از کاره، و دوما حتی شاید ششدنگ بادقت باشیم ولی یه چیزی رو ندونیم یا تصویر کامل رو نداشته باشیم. review و تست برای همینه دیگه، نه برای مشکوک بودن به افراد!
ما در دیجیکالا یک سیستم ساده و مقیاسپذیر برای A/B testing طراحی کرده بودیم تا جای سیستم قبلی که گلوگاه توسعه شده بود رو بگیره و به سیستمهای آماده موجود هم بصرفه (هرچند این طرح رو هم مثل بقیه نهایتا نشد که در اون سازمان به ثمر برسونیم). یکی از چیزهای مهمی که قرار بود این سیستم بهش نظم بده این بود که در مدل کاری اونجا، که کارفرما و تحویلگیرندهی سیستم A/B testing و اپراتور این سیستم میشد تیم محصول و PMها (و این برای من شخصا خیلی عجیب بود)، افراد نتونن بنشینن پشت پنل چنین سیستمی و با چندتا کلیک در یک UI، رفتار سیستم رو در production تغییر بدن. تکرار میکنم که مساله سوءنیت افراد نیست بلکه قداست productionئه.
تله: اما تلهی این رویکرد «همه چیز به شکل کد» چیه؟ وابستگی production به Gitlab و Gerrit! ما برای اتکاپذیری سرویسمون در production، چند لایه ایمنی و oncallهای ۲۴x۷ و غیره داریم. برای Gitlab و Gerrit هم داریم؟ طبیعتا نه؛ اینا ذاتا برای محیط development هستن و نه محیط production. کاملا ممکنه که Gitlab پایین باشه و این نباید باعث خطا در production بشه بلکه نهایتا باید باعث دادهی کهنه (stale data) بشه. بنابراین به ویژه در ابزارهای اولشخص، مثلا همون زیرساخت A/B test (هنگام خوندن تعریف آزمایشها) یا pipelineهای تجمیع داده (هنگام خوندن تنظیمات data cubeها) و غیره، نباید مستقیما چیزی رو از codebase بخونیم - حتی اگر cache کنیم (اگر در هنگام پایین بودن Gitlab به restart خوردیم چی؟). حتما باید یک لایهی pub/sub-طور بین codebase و production باشه و وظیفهی snapshot گرفتن از codebase و push کردن به محیط production رو انجام بده.
جالب اینه که این اشتباه، وابستگی مستقیم به codebase در production، در گوگل خیلی مرسوم بود، چون سیستم مدیریت مخزن کد (Piper) اینقدر اتکاپذیر بود که هیچکس به اختلال داشتنش فکر نمیکرد - و همیشه SREها بالبال میزدن که آی ملت این کارو نکنید. متاسفانه یکی از گولزنکیهای سیستمهای همیشه بالا هم همینه. یک مثال نامرتبط به مطلب اصلی ولی جالب: یک بار صاحبان یکی از پایهایترین سرویسهای داخلی گوگل (یک distributed lock service به اسم Chubby، یه چیزی شبیه ZooKeeper)، دیدن از SLOشون (مثلا ۹۹.۹۹٪) خیلی جلوترن و بقیه دارن روی سیستمشون بیش از SLOاش حساب میکنن. رفتن از قصدی اختلال کنترل شده ایجاد کردن که بقیه یه سیخی بخورن و در مهندسی سیستمهاشون، اختلال در Chubby رو هم لحاظ کنن.