

· 微博创始团队成员,小米和美团老牛马 · 持续更新 AI 实操教程,全在个人网站 https://teapawt.org/t.co/3i6TldDNnX · 专精 DeepSeek Harness,代理 WorkBuddy · 已做百场线下培训,帮更多人和企业用好 AI
wuhan,china
Joined November 2008
- Tweets3.7K
- Following4.9K
- Followers12.5K
- Likes455




作为一个给他们家拉新了接近 100 个的老用户,我现在强烈推荐不要再用他们家了。
他们家自从虚拟卡被干掉之后,现在还能提供的服务就是最常见的菲区代充。
不过这菲区代充收美区的钱还要外加手续费是不是也太贵了点?Pro 200 的市面行情价都已经被打到 1000 出头了,我为啥还要花 1500 去享受完全一样的服务呢?
现在的野卡已经不是此前的那个野卡了,不如相忘于 AI 江湖就此别过吧。


现在国内想给 ChatGPT 开个会员太 tm 折磨了!风控严就算了,付款就能卡死一大片人:
没海外卡,去某宝找代充又怕碰上黑卡或低价区,封号直接血本无归
折腾了一圈,目前我自己续费最稳的方式是 bewild: 直接给自己的官方账号代充,不用交密码,在网页端按提示授权一下账号状态,微信就能扫码付。走我的链接还能直接立减 7 元专属优惠,相当于跳过了办外卡和低价代充的坑,适合想要自己独立号、长期重度用的人
如果你只是偶尔想用用、不想每个月硬掏 20 刀开会员,直接去看 2233 这种聚合站更划算:
国内网络直接开,免翻墙也免注册外区号,一个窗口里 GPT-6.1 Sol、Claude Fable 5.2、Gemini 4 Carbon 都能切着用,$0.99 就能玩好久呢~
需要的我已经放到评论区了 👇

4
7
3,873
哎,看到有人分享说 OpenCode Go 里面的 DeepSeek Flash 能跑到接近 300+ token/s,兴冲冲去充了个值,结果测试了一下不到 100 token/s,还不如 WorkBuddy + Magpie 能跑到 150 token/s 呢。
算了,看在 10 美元套餐能有 10x 到 100 美元额度的份上忍了,给丫几个需要使用 Browser Use 的自动化爬虫慢慢跑吧。
发现最近有点 Token 饥渴症,症状和那些一毛钱抢一版鸡蛋的大妈有点像。
得多留个心眼了,要不哪天得被骗个大的。

OpenCode Go + DeepSeek is at 275 tok/s.
normally i’ve been seeing something closer to 60-90 tok/s.
but today it’s been sitting at 220-250 tok/s for hours, with peaks at 275 tok/s.
i’m running DeepSeek V4.1 Flash through DeepSeek Harness, and the difference is very noticeable.
one possible explanation is that OpenCode’s inference team figured out a better way to host DeepSeek and also added more compute.
there’s some uncertainty around how TPS is measured across different harnesses, but the speed improvement itself looks very real.
if this level of performance stays consistent, OpenCode Go just became a lot more useful.
作为刚从 Pro 500 退回 Pro 200 的老韭菜,分享一点我的个人体验吧。
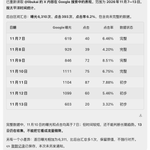
1. Pro 200 目前是 ChatGPT 订阅中性价比最高的套餐,看我贴图中的商家售价,一个 Pro 500 够买三个 Pro 200 了,总体额度加起来还会更高一些。
2. Ultrafast 名不副实,不管是 Astra 还是 Sol,我的实测很少有过 100 token/s 的时候,根本就达不到号称的 8x 速,反而是 Fast 总体来说达到 1.5x 速还是比较稳的,从性价比来也是足够高的。
3. 跟着 Pro 订阅送的 API 额度可千万别浪费了,这是全类型 API 都可以调用的额度,光是最高等级的生图模型用起来就非常爽,Decision API 其实也很不错,用来跑一些独立的 AI 小项目绰绰有余。
最后,请跟我一起轻轻说:I'm back, Altman.


老黄桃色新闻的背后阴谋现在看起来已经基本明了,就是想借这个事情把输中算力的灰色通道给彻底卡死。
根据 WSJ 的调查报告,老黄还是为输中算力暗地里做了不少事情的,军功章有梁圣他们的一半,也得给老黄记上一半,🥇。
WSJ从马来西亚工地、云服务商融资材料和芯片运输记录追踪中国企业取得英伟达算力的两条路径:把芯片运入中国,以及租用东南亚数据中心。黄仁勋离任后,美国准备收紧远程算力规则,可能改变当地数百亿美元投资的商业基础。
1. 马来西亚Senawang一处在建数据中心覆盖约117个足球场,由BlackRock支持的Vena Group建设;知情人士称阿里巴巴计划在其中使用英伟达服务器。工地工人以孟加拉国和印度尼西亚劳工为主,基础设施由运营商建造后出租给安装自有硬件的科技公司。
2. 英伟达截至7月26日的半年披露中国收入124亿美元、占全球7%;做空机构Culper估计,上财年超过20%的收入最终受中国需求驱动。两者分别为公司地区收入披露与研究机构对最终需求的估算。
3. WSJ看到的记录显示,Megaspeed在2024年3月至2025年6月安排向中国公司运送近120亿美元先进芯片,订单涉及数十万颗芯片;记录没有说明最终交付量或货源地。Megaspeed称业务合法、遵守出口规则,已聘外部律师调查。
4. 美国对Super Micro联合创办人Wally Liaw等人的起诉书描述,一批服务器经东南亚转运中国后,相关人员搭建假仓库应付审查,还用吹风机移换序列号贴纸。Liaw不认罪,审判定于明年;未被起诉的Super Micro称自己是受害者,并已与被告断绝关系。
5. 另一路径是中国客户合法租用海外数据中心的高端芯片。特朗普政府2025年5月撤回拜登政府拟限制东南亚等国芯片进口的计划,18个月后仍未推出替代措施。有中国开发者在东南亚使用芯片训练后,把装载数据的硬盘带回中国。
6. 知情人士称,Alice Huang及同事借与黄仁勋的关系进入英伟达云伙伴名单;伙伴可优先取得稀缺芯片,常需先证明已有大型客户,Megaspeed对应的客户是阿里巴巴。
7. WSJ取得的新加坡Aolani Cloud投资材料把地缘限制描述为商业机会:无法直接买芯片的中国互联网公司必须租用算力。投资者帮助其截至今年初在马来西亚配置约25亿美元硬件,锚定客户为字节跳动;公司称严格遵守美国规则并面向全球客户。
8. 研究员James Chai称马来西亚吸引超过340亿美元数据中心投资。DayOne近期文件披露单一客户占业务近70%,知情人士称为字节跳动;公司还在马来西亚、印度尼西亚建设可容纳英伟达芯片的设施。
9. 知情人士称,英伟达自去年起要求部分海外云伙伴把中国客户占比压至30%—49%之间,但未写进合同;公司也曾敦促部分伙伴减少中国籍高管及中国投资者。云服务商开始关注日本、巴西、中亚和欧洲的新容量。
10. 美国商务部正拟把马来西亚、印度尼西亚及新加坡纳入出口限制,要求Blackwell等高性能芯片出货获许可,并禁止中国客户远程使用其算力。马来西亚周五表示不会成为绕过出口管制的通道,正调查Megaspeed及当地关联公司是否再出口AI芯片。

1
1,428
看了一下网站的内容,抓的质量还真不错,👍
比看千篇一律的新闻有价值多了,值得每天扫一下跟进最新的玩法。

正式给大家介绍一下
「X榜单」的兄弟站: xfeed.ai
目前实时追踪了1400+个AI博主
每3小时自动更新一次
如果你每天刷 X 感觉信息过载
但又怕错过最新的 AI 玩法
那我新做的这个网站
应该能帮你省下80%的检索时间!
网站还有很多不完善的地方
欢迎大家多提意见!

玩了两个星期的 DeepSeek Harness,然后又花了两天时间把配置、插件和技能全部梳理了一遍。
现在只缺一个能让我无限爽用的 DeepSeek Token 订阅计划,我就能宣布这是当下最好用的 Agent Harness 了。
期待下个月就能从 ChatGPT Pro 200,切换到 DeepSeek Pro 200。


嗯,这段时间我也在总结用 DS-Bot 或者说用 Personal Agent 做非编程工作的经验和教训。
如果说开发编程类工作的切入点是目标和验收,那么我觉得非编程类工作的切入点就是自动化任务。
例如我每天早上要收 3 份新闻日报、1 份 SEO 日报,以及1 份爬虫日报。
之前,这些自动化任务分散在 ChatGPT、n8n 以及我自己构建的爬虫当中,然后通过 serverchan 统一发送通知给我。
在一切正常的时候,每天看这些通知当然是很愉快的。但是,总会有一些意外情况,导致我没法收到通知,还得手动去调用 AI 工具处理出现的问题。
现在,我在 DS-Bot 中为每一个日报新建了一个定时任务,然后在任务详情中授予了对应设备的 SSH 访问权限,现在每天他们都主动会去帮我检查任务的执行情况,如果发现有问题就自动去做处理,直到顺利执行完毕。
同时,对于做课件这种需要反复和 AI 沟通,讨论想法和调整细节的任务,我依然是偏好“经典”模式。
尤其是在我自己构建了专属的课件插件之后,可视化和对话框实现了完美的融合,这样的效率相对两者割裂时大大提升了。
在目前这个阶段,我依然是处在两者兼顾的状态。但我非常确定,未来一定会逐步把所有的任务都自动化,这也是我经常表达的一个观点:
整个社会将快速跳过人和 AI 协同的智能化阶段,而直接从全人工的信息化阶段跳到全 AI 的自动化阶段。
也许能阻挡这个趋势的,只有人类证明自己价值的执念了。

很很多开发者交流了一下,一个比较普遍的共识是,传统的 session 是非常低效的使用方式,甚至可以说是在摧毁人的精力和注意力。但是仍然有很多朋友是坚持这种传统用法的,我觉得这是一个急需改变的习惯。我分享一下我自己的 dsbot 的用法,大家可以参考一下。(这也是为什么我之前短暂去掉过经典 agent 模式的快捷切换)
就拿 dsbot 本身的开发工作举例,我基本上只和 2-3 个 bot 来沟通,一个主要沟通我称为“助理”,承担着大概 60%的沟通;另外两个分别是 issue、bug 的处理员1 和优化点子的处理员 2。另外我还有个专门负责对齐我目标的 bot。
我的使用方式就是,大部分工作都和“助理”来交流,偶尔有专门的任务我会和两个处理员直接沟通。由这些 bot 来去协调其他的 worker,我有大概 20 个 worker bot,我几乎从来不和他们说话。
我有很多定时任务,每天会自动批量跑。我会定时去“收菜”。我之前也展示过,大概就是 bot 会使用一个可视化、可交互的卡片,然后我勾选合并的 pr,剩下的废弃。
这就把人的注意力从 1→无数个 sessions 变成了 1→1-3 个 bot。发布工作、验收工作始终都在这个bot 的窗口来完成,不需要切换别的窗口。而且得益于 dsbot 的交互式 ui,你可以清晰的看到有什么待办,这样你的思路会很清晰、有条理。
没尝试过这个用法的朋友真的无法想象这能带来多大的精力节省和注意力提升。我非常推荐在使用 dsbot 的朋友来使用这个用法。不要再去使用一个个一次性的 session,不要再去在乎 agent 的工作过程,专注于目标和验收,这是最重要的两点。
dsbot 仍然做了妥协,带回了经典 agent 模式的切换。不过我希望大家都能进行一些更大胆的尝试,去试试我上面说的这个方法,绝对能带来非常大的帮助!
昨天推荐了 DeepSeek Harness 搭配 ego-lite 来执行浏览器自动化任务。
今天我们来看看如何在 DSH 中执行另一种自动化任务 —— Computer Use,也就是操控电脑上的应用。
相对来说,Computer Use 的难度比 Browser Use 还是要大不少的,因此还挺难找到一个合适的工具。
寻找了一圈之后发现,其实在 DeepSeek Harness 中已经在逐步增强这个能力,在 v0.1.6-alpha.1 版本引入了基于 CUA Driver 的相关能力,而从 v0.2.2-alpha.2 版本开始,在实验性插件中提供了 Mac 端的用户可用的插件。
这个 CUA Driver 其实很值得说一说,不少开源项目都不约而同的选择了它作为 Computer Use 的底层架构。
首先,这个工具支持后台模式,也就意味着 AI 执行任务时,不会和你抢鼠标和键盘,这和 ego-lite 的设计理念一致,也是我的核心需求之一。
其次,Cua Driver 速度和准确率目前看起来都是同类产品中最高的,这一点得到了 @DashHuang 大佬的认证,它的 Cindy 里的 Computer Use 也采用了这套方案作为基础。
最后, DeepSeek Harness 使用的方案从 v0.28.0 就和上游分叉了,把 Mac 上的操纵机制改为了自己原生的 Swift helper方案。
本来我是想试试用原生的 CUA Driver 是否会更好一些,但折腾了一轮之后,发现还不如直接用 DeepSeek Harness 官方的版本。
当然更可能是我的水平问题,还期待有大佬能够把完整的 CUA Driver 的能力带到 DeepSeek Harness 中。
作为一个还处在早期阶段的实验性项目,DeepSeek Harness 的原生能力相对 Codex 的能力差距还是非常大的。
包括后台输入经常无法被识别,元素和点击坐标识别不准,还有很多的 App 中私有化的功能支持不到位。
更有趣的是,也许是专门针对 DeepSeek 的模型做过适配,在使用 V4.1 Flash 的时候,准确率要比 GPT-6.1-Sol 高的多。
总之,在这个阶段,这个功能暂时还只能用来做做测试玩一玩,就不要太过于依赖了,如果真有需求,还是出门左转找 Codex 吧。

虽然传播很广,但这个视频的真实性得先存疑,暂时只有这个粉丝运营的@Optimus_RH 账号发了相关的内容。
然后我去这个哥们的账号中看了一眼,基本都是用 AI 做出来的各种 Optimus 的内容,比如我在下面贴的这个。
毕竟以马斯克的骚包性格,这么装逼的事早就该由他自己昭告天下了。

1
4
1,191

DeepSeek Harness 的创造模式用嗨了之后,就完全挡不住随心所欲雷霆大改的冲动。
让它自己去梳理了一下当下现状,发现已经整了十多个本地的插件,包括完全自产和魔改他人。
为了长治久安,正在整体清理,还是用 Git 的方式都管起来。
感觉搞完了,就能建一个索引源,把分享做得更方便一些。
8
19
4,620
一个好的域名还是有很有价值的。
例如我现在出去参加活动或者讲课介绍自己,都是说我叫李不凯,个人网站就是我姓名的全拼,大家在最后的 ai 前面加个点就行了。
虽然一年要 680,但感觉这个逼装的值啊,😆

认真做 X 的兄弟们,可以考虑在 Google Search Console 中把自己的 X 账号添加进去。
看了下 DS-Bot 给我的报告,最近几天 X 内容在 Google 搜索中的曝光都超过了 1K,点击也有大几十次,已经能看到搜索带来的流量慢慢起来了。
以前更关注 X 站内的推荐,现在发现,发出去的内容也可能通过 Google 搜索持续被人找到。
一举两得,何乐不为?

3
9
1,235
大模型吞噬一切又有新的受害者,机器人专属模型行业天都塌了。
OpenAI向Fortune确认,将独立机器人团队拆分并入通用研究与Applied体系,而非放弃机器人。
公司称GPT-6 Astra等通用前沿模型已可直接用于机器人,令年初围绕Sora发展机器人模型的思路改变;研究者同时指出,真实部署数据、低延迟与离线模型仍有独立价值。
1. OpenAI机器人研究人员被调入由首席研究官Mark Chen负责的主研究团队;应用机器人和硬件团队则并入总裁Greg Brockman领导的Applied组织。公司强调机器人仍是长期愿景核心,此举旨在加速通用机器人研发。
2. 调整发生得很近:OpenAI已报名本周在奥斯汀举行的CoRL会议208号展位,会议应用和地图仍标着它,但Fortune到访时展位空着、没有标识和演示。一些原独立团队成员仍在现场交流并吸引参会者。
3. OpenAI早期就有机器人团队,2020年收缩,联合创始人Wojciech Zaremba后来归因于机器人数据有限,以及其他方法通向AGI更有效率。公司随后集中训练超大语言模型,最终在2022年底推出ChatGPT。
4. 公司2024年重建独立机器人团队,并与Figure合作研发人形机器人模型;合作于2025年2月结束,Figure称将自研AI。OpenAI仍在研发自家人形机器人,Altman目标2027年首次公开演示。
5. OpenAI称年初原本认为,机器人进步应建立在Sora这类隐含理解物理世界的视频模型上;后来发现GPT-6 Astra等通用模型可直接应用于机器人,因此将研究人员移往通用模型团队。
6. 卡内基梅隆大学Guanya Shi将这看作OpenAI不再把机器人视作特殊问题,而把它视为通用智能的一种下游应用,类似同一基础模型支持代码、法律或金融工具。
7. 报道描述的试验向Astra提供摄像头图像、机器人信息与控制接口。在英伟达的一项模拟操纵基准中,Astra代理成功率74.8%,对照该榜单最佳专用机器人模型51.0%;这是数字模拟环境,不是实体机器人测试。
8. Shi认为通用模型已能处理瓶子位置、光照改变等情况,并推理任务步骤和错误;但大模型较慢、通常云端运行,机器人因此需要持续联网。他仍看好能在机载电脑离线运行的小型专用模型。
9. MIT教授、Walden Robotics联合创始人Russ Tedrake指出,机器人公司已在工厂等真实场所积累部署经验和数据。更强基础模型让这些现场数据更值钱,因为机器人能更快从中学习。
10. Generalist联合创始人Pete Florence认为,智能可以从不同起点发展,还无法确定现有哪种模型最终主导机器人。

6
2
1,196
这不就是我正在做的事嘛!
已经把任务管理、订阅管理、课件制作等日常工具,迁移成了 DeepSeek Harness 中可以随时进化的插件,接下去还会把更多的日常需求移植进去。
还有一个小小的建议:要不考虑一下把“创造模式”改名为“许愿模式”吧,正好和 Vibe Coding 的中文翻译“许愿式编程”对应上,对普通人而言这个词也更好接受一些。


