
«La justicia es la primera virtud de las instituciones sociales, como la verdad lo es de los sistemas de pensamiento» Rawls, J. Ciencia Política UNR Docente
Rosario - Santa Fe - Argentina
Joined July 2007
- Tweets5.3K
- Following1.1K
- Followers1.4K
- Likes49.9K






Marcelo de la Torre retweeted

Desde que Cerimedo mandó asesinar a su amante embarazada, nada les sale.

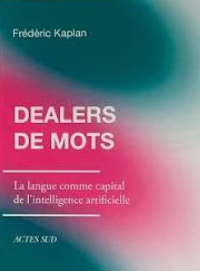
Las grandes corporaciones detrás de las #IA están desesperadas por encontrar nuevos materiales con los que alimentar y entrenar sus modelos. Después de explotar enormes cantidades de datos públicos y disponibles en abierto (por ejemplo, algunos sistemas de traducción automática fueron entrenados con las transcripciones multilingües de los debates del Parlamento Europeo), ahora ponen la mira en las colecciones privadas, desde libros viejos hasta correos electrónicos y archivos personales. La materia textual humana vale mucho.
Desde hace casi un milenio, las universidades son gigantescas máquinas textuales. Su producción es enorme: trabajos prácticos, finales, exámenes y apuntes, sin contar los artículos y libros que producen sus profesores e investigadores. Se trata de instituciones que viven de la producción, circulación y evaluación de la textualidad humana. Un bocado demasiado precioso como para dejarlo pasar.
Creo que se pueden plantear algunos escenarios novedosos: desde universidades que decidan vender sus textos, como sucede con los libros de segunda mano adquiridos para entrenar los modelos de Anthropic (ver el Proyecto Panamá: rtve.es/play/noticias/202610…), hasta instituciones que prohíban ese tipo de apropiación. También podrían presentarse situaciones intermedias, por ejemplo, intercambios entre universidades y empresas como Alphabet o Microsoft: viejas tesis y trabajos finales a cambio de servicios tecnológicos. ¿Cuánto vale el archivo textual de una universidad?
Sabemos que entrenar de manera recursiva una IA con textos generados por otras IA puede degradar su rendimiento (endogamia textual). Si vamos un poco más allá, podemos preguntarnos qué pasaría si las IA llegaran a procesar TODA la textualidad humana producida en los últimos seis milenios. Sería como imaginar un mundo sin petróleo. Mientras pensamos la respuesta, cuidemos los viejos textos.
"AI Companies Really, Really Want to Buy Your Work Files and Emails. Data brokers are collecting all sorts of internal corporate files to help train AI models. Not everyone is thrilled! wired.com/story/ai-companies…

2
126
Las grandes corporaciones detrás de las #IA están desesperadas por encontrar nuevos materiales con los que alimentar y entrenar sus modelos. Después de explotar enormes cantidades de datos públicos y disponibles en abierto (por ejemplo, algunos sistemas de traducción automática fueron entrenados con las transcripciones multilingües de los debates del Parlamento Europeo), ahora ponen la mira en las colecciones privadas, desde libros viejos hasta correos electrónicos y archivos personales. La materia textual humana vale mucho.
Desde hace casi un milenio, las universidades son gigantescas máquinas textuales. Su producción es enorme: trabajos prácticos, finales, exámenes y apuntes, sin contar los artículos y libros que producen sus profesores e investigadores. Se trata de instituciones que viven de la producción, circulación y evaluación de la textualidad humana. Un bocado demasiado precioso para entrenar los LLM como para dejarlo pasar.
Creo que se pueden plantear algunos escenarios novedosos: desde universidades que decidan vender sus textos, como sucede con los libros de segunda mano adquiridos para entrenar los modelos de Anthropic (ver el Proyecto Panamá: rtve.es/play/noticias/202610…), hasta instituciones que prohíban ese tipo de apropiación. También podrían presentarse situaciones intermedias, por ejemplo, intercambios entre universidades y empresas como Alphabet o Microsoft: viejas tesis y trabajos finales a cambio de servicios tecnológicos. ¿Cuánto vale el archivo textual de una universidad?
Sabemos que entrenar de manera recursiva una IA con textos generados por otras IA puede degradar su rendimiento (endogamia textual). Si vamos un poco más allá, podemos preguntarnos qué pasaría si las IA llegaran a procesar TODA la textualidad humana producida en los últimos seis milenios. Sería como imaginar un mundo sin petróleo. Mientras pensamos la respuesta, cuidemos los viejos textos.
"AI Companies Really, Really Want to Buy Your Work Files and Emails. Data brokers are collecting all sorts of internal corporate files to help train AI models. Not everyone is thrilled! wired.com/story/ai-companies…
There's a new version of this post
4

#digicomunr
"𝑬𝒍 𝒄𝒐𝒎𝒑𝒓𝒐𝒎𝒊𝒔𝒐 𝒉𝒖𝒎𝒂𝒏𝒐, 𝒍𝒂 𝒐𝒓𝒂𝒍𝒊𝒅𝒂𝒅 𝒚 𝒍𝒂 𝒅𝒊𝒔𝒄𝒖𝒔𝒊𝒐́𝒏 𝒅𝒆𝒃𝒆𝒏 𝒗𝒐𝒍𝒗𝒆𝒓 𝒂𝒍 𝒄𝒆𝒏𝒕𝒓𝒐 𝒅𝒆 𝒍𝒂 𝒆𝒏𝒔𝒆𝒏̃𝒂𝒏𝒛𝒂 𝒚 𝒅𝒆𝒍 𝒔𝒊𝒔𝒕𝒆𝒎𝒂 𝒅𝒆 𝒄𝒂𝒍𝒊𝒇𝒊𝒄𝒂𝒄𝒊𝒐́𝒏. 1/2
1
2
68

Marcelo de la Torre retweeted
FELICITACIONES… primero al pueblo brasileño que hoy protagonizó un auténtico 17 de Octubre electoral y después… a usted, compañero presidente Lula, que en su séptima elección presidencial supo despertar en sus compatriotas sentimiento y sentido para ganar esta batalla.

"... 𝘾𝒐𝙢𝒆𝙣𝒛𝙤́ 𝙝𝒂𝙘𝒆 𝒔𝙚𝒊𝙨 𝙢𝒆𝙨𝒆𝙨 𝙘𝒐𝙣 53 𝒎𝙞𝒍 𝒑𝙚𝒓𝙨𝒐𝙣𝒂𝙨 𝙘𝒐𝙣𝒆𝙘𝒕𝙖𝒅𝙖𝒔 𝒚 𝒉𝙖𝒔𝙩𝒂 𝒉𝙤𝒚 𝒄𝙧𝒆𝙘𝒊𝙤́ 𝙖 9.418.904. 𝑨𝙪𝒎𝙚𝒏𝙩𝒐́ 𝒆𝙡 17.669,81 𝙥𝒐𝙧 𝙘𝒊𝙚𝒏𝙩𝒐. 𝙐𝒏𝙖 𝙡𝒐𝙘𝒖𝙧𝒂."
pagina12.com.ar/2026/10/23/e…

1
44

Marcelo de la Torre retweeted

📣En el Día del Derecho a la Identidad ayudemos a Abuelas de Plaza de Mayo a recuperar el contenido de su cuenta @abuelasdifusion
Está en revisión desde hace una semana por @support @safety
Son 49 años de lucha. En su día necesitamos amplificar la búsqueda


Marcelo de la Torre retweeted

Tener una fascinación con el costado íntimo de un genocida es una cosa que le pasa a los hijos de puta

"Hay un costado íntimo de Videla que no se conoce": Mario Massaccesi contó que está realizando un documental que explora una faceta poco conocida del dictador y aclaró que eso no lo convierte en "un buen presidente".
#OtroDíaPerdido

#digicomunr
—¡El horror! ¡El horror! ... APOCALIPSIS NOW
El corazón de las tinieblas de Conrad... lo primero q me viene a la mente
Anthropic interdit la "cruauté gratuite" envers son Claude, son assistant d'intelligence artificielle – franceinfo franceinfo.fr/internet/intel…

69