

東北大学 ロボティクスコース 教授 / IEEE Fellow / 日本機械学会 フェロー / MEMS Engineer Forum 代表 / 自動車部 部長 / JST ACT-X 研究総括 / 「近代技術史学」講義担当 / 日経xTECHに執筆 / 山口県出身 / MEMS、半導体、産業史などについてポスト
Sendai
Joined May 2021
- Tweets1.5K
- Following892
- Followers12.5K
- Likes80.4K
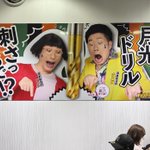



米子空港で目に付いた「月光ドリル」の広告。これは刃先を切り欠いて三日月状にした独自のドリルで切削性と食い付き性に優れ、整形外科でも使われているそう。そのメーカーは鳥取県米子市近郊・日吉津村の地元企業であるBIC TOOL。一瞬、チャックで有名なBIG(大昭和精機)かなと思ったが、全く違う。

OCS(Optical Circuit Switch)は光ファイバーバンドルの経路を切り替えるデバイス。MEMS方式、液晶方式、シリコンフォトニクス方式などがある。MEMS方式はCalient․AI、Lumentum、Molexなどから出ているが、Googleが独自のものを自社開発してから特に注目されている。その開発には8年を要したそうだ。


私達はいつも突然の不景気から逃げ遅れてしまう。サプライチェーンが幾層にもなり、リードタイムが長く、しかも規模が大きい産業でそれから逃げるのはほとんど無理そうだ。先のポストでは単純化したモデルで少しの需要減退が急激な納期短縮に繋がることを述べた。納期が短くなれば余剰在庫が発生する。
先のポストのように40カ月だった納期が4カ月になれば、単純に必要となる基準在庫量が10分の1になるので、旧基準で抱えていた在庫の約9割が余剰になる。そうすると、手元の在庫が納期4カ月の水準まで自然消費される間、新規発注が止まる。たとえば、手元に24カ月分の在庫があれば、約20カ月間も発注する必要がなくなる。
在庫削減はキャッシュフロー改善とコスト削減の基本だから、当然、この状況は買い手には望ましい。サプライヤーにとっても生産計画が立てやすくなり、工場の稼働率が安定するので、工場に過剰投資をしていなければ、この状況は長期的には望ましい。しかし、しばらく受注が止まるため短期的には業績に大打撃となる。需給逼迫(ρ≒1)時にはたった2割の需要減で突然の大不況が起こりうる。これからは逃げようがなさそうだ。
ところで、公称納期が40カ月と4カ月の時にどのくらいの量を発注すべきかはもう少しきちんと計算できる。公称納期が40カ月と4カ月の時、それぞれ平均納期は36カ月と3.6カ月、標準偏差σは3.6カ月と0.36カ月であるとし、納期は正規分布すると仮定する。サプライヤーとして納期に遅れることはヤバいので、実際には納期はこのような分布にならないが、ここでは話を単純化している。
欠品率を1%にしたいなら、それぞれ1回の発注数(最大在庫数)は約44.4カ月分と約4.44カ月分となり、欠品率を0.1%にしたいなら、それぞれ1回の発注数は約47.1カ月分と約4.71カ月分となる。たまに欠品しても仕方ないと割り切れば、在庫を減らして低コスト化ができるということだ。B2Bでは欠品は許されないだろうが…
🤖 Made with AI

AIサーバーの金融構造的リスクが現実化すれば、AI半導体の需要が2割程度は減るかもしれない。仮にそうなれば伸びに伸びた納期も2割程度は減るだろうと思うかもしれない。しかし、待ち行列理論によるとその変化は急激で、注文後即製造着手に近い状況になる。これについて「数学的物語」を語ってみる。
4棟の半導体工場があるとして、待ち行列理論のM/D/4モデルを仮定してみよう。これは現実に即したモデルではないので、「数学的物語」として読んで欲しい。利用率ρを「単位期間に来る注文の件数を同じ期間に工場群が納品できる件数で割った値」と定義する。
今、需給が逼迫していてρ=0.99だとすると、約49件の注文が長い待ち行列を作る。1件分のAI半導体の製造期間が3カ月だとすると、納期は約40カ月と長くなる。ここで需要が約2割だけ減ってρ=0.8になったとする。そうすると、待ち行列の長さは約1件に、納期は4カ月強に激減する。製造期間が3カ月だから、注文後約1カ月で製造に着手してもらえるのだ。たった2割の需要減によってビジネスの景色が大きく変わることがわかるだろう。
2割の需要減の影響は実際にはもっと大きいかもしれない。納期が長くなると顧客は欠品を恐れて実際の必要数を上回る発注をする。サプライチェーンがn段階になっているとして、各段階で20%増しの発注(ファントムオーダー)が行われると(1.2のn乗)倍の注文数が最上流に来る。n=5の場合、見かけの需要は約2.5倍に増幅するのだ。
ここで需要が2割減になって納期が劇的に短くなれば、このファントムオーダーによる見かけの需要も無くなり、(1.2のn乗)倍に膨らんでいた最上流の注文は一気に剥落する。これはサプライチェーン下流の変動が上流に行くと増幅される「ブルウィップ効果」である。そして、納期が十分に短くなれば高騰していたAI半導体の価格はいずれ正常化するだろう。もちろんここでLTA(Long-Term Agreement)は考慮していない。

中国のMEMS業界でもAIサーバーとフィジカルAI・ロボティクスにビジネスの興味が集中している。昨年からすっかり変わったという印象だ。多くの経営陣がOCS(Optical Circuit Switch)、TFLNモジュレーター、シリコンフォトニクス、ロボット向けの触覚・力覚センサーや慣性センサーについて語っていた。

AIサーバーの金融構造的リスクが現実化すれば、AI半導体の需要が2割程度は減るかもしれない。仮にそうなれば伸びに伸びた納期も2割程度は減るだろうと思うかもしれない。しかし、待ち行列理論によるとその変化は急激で、注文後即製造着手に近い状況になる。これについて「数学的物語」を語ってみる。
4棟の半導体工場があるとして、待ち行列理論のM/D/4モデルを仮定してみよう。これは現実に即したモデルではないので、「数学的物語」として読んで欲しい。利用率ρを「単位期間に来る注文の件数を同じ期間に工場群が納品できる件数で割った値」と定義する。
今、需給が逼迫していてρ=0.99だとすると、約49件の注文が長い待ち行列を作る。1件分のAI半導体の製造期間が3カ月だとすると、納期は約40カ月と長くなる。ここで需要が約2割だけ減ってρ=0.8になったとする。そうすると、待ち行列の長さは約1件に、納期は4カ月強に激減する。製造期間が3カ月だから、注文後約1カ月で製造に着手してもらえるのだ。たった2割の需要減によってビジネスの景色が大きく変わることがわかるだろう。
2割の需要減の影響は実際にはもっと大きいかもしれない。納期が長くなると顧客は欠品を恐れて実際の必要数を上回る発注をする。サプライチェーンがn段階になっているとして、各段階で20%増しの発注(ファントムオーダー)が行われると(1.2のn乗)倍の注文数が最上流に来る。n=5の場合、見かけの需要は約2.5倍に増幅するのだ。
ここで需要が2割減になって納期が劇的に短くなれば、このファントムオーダーによる見かけの需要も無くなり、(1.2のn乗)倍に膨らんでいた最上流の注文は一気に剥落する。これはサプライチェーン下流の変動が上流に行くと増幅される「ブルウィップ効果」である。そして、納期が十分に短くなれば高騰していたAI半導体の価格はいずれ正常化するだろう。もちろんここでLTA(Long-Term Agreement)は考慮していない。
最新の大規模AIデータセンターは消費電力100 MW超に達する。これは日本最大の一般水力発電所である奥只見発電所の平均出力120~150 MWに匹敵する規模だ。そこで電力系統制約や受電規制が話題になるが、これらはNeocloudの破綻に繋がりかねない。電力効率の高いAIサーバーへの更新が加速するからだ。
主要なNeocloud(CoreWeave、Lambda等)は投資ファンド等からの資産担保融資でGPUを調達し、AI企業(OpenAI、Anthropic等)やハイパースケーラー(Google、Microsoft、Amazon等)に3〜4年のTake-or-Pay契約で貸し出すビジネスモデルを採っている。しかし、電力効率に優れた新型機への世代交代が急激に進むと、担保である保有AIサーバーの資産価値が想定以上のペースで下落してしまう恐れがある。つまり、AI半導体の急速な技術革新が担保価値を毀損させるリスク要因の1つになりうる。
保有AIサーバーの担保割れが生じた際、巨額の負債を抱えるNeocloudが追加担保に応じられなければ、破綻に追い込まれる懸念がある。さらに、減価償却を4〜6年と長めに設定しているのに対し、長期利用契約は3〜4年で終了することが多いのも懸念材料だろう。契約終了後、電力効率で劣る旧型機のレンタル単価は急落するかもしれないからだ。
仮にNeocloudが破綻すれば、NVIDIAも無傷では済まないはずだ。出資持分の減損に加え、担保だったGPUが中古市場へ投げ売られると新品価格が急落しかねない。さらに、GPUの販路が大手ハイパースケーラーに絞られることで、価格交渉力が弱まる可能性もある。直接の損失を被るのは融資元の投資ファンドに出資する年金基金や生命保険会社であり、最終的には一般市民なのだが…
NVIDIAもこのシナリオは避けたいはずだ。一方、計算資源を長期契約したAI企業にとっても既存AIサーバーの急速な劣後は避けたいところだろう。高値で長期契約した計算資源を使い切る前に、最新機を安価に借りた新興勢力に逆転されかねないからだ。AI半導体の発展はAI企業にとって事業のドライバーであるものの、皮肉にも既存ハードウェアの急激な陳腐化によって自社の巨額投資が回収不能になるリスクにもなりうる。
安全規制を主導するAI企業が「人類の危機」を唱える裏には、巨額投資の回収期間を稼ぎ、長期契約した計算機インフラの陳腐化を防ぐ狙いもあるのではないかと邪推する。さらに、AIの安全規制は後発企業の参入を阻む障壁の1つにもなりうる。一方、AIチップの内製化を強化するハイパースケーラーと競合するNVIDIAにとっては、減収によって開発原資の確保を難しくするようなAI規制は受け入れ難い。
この構図において、相対的に有利な立場にいるのはハイパースケーラーかもしれない。彼らにとってNeocloudは需要急増時の一時的な外部調整弁、あるいはオフバランスシートの計算資源という側面が強く、本業のキャッシュ創出力も圧倒的だ。GPUの価格が落ち着けばNVIDIAへの交渉力が増し、投げ売りされたデータセンター資産を安値で取得する余力も十分にありそうだ。
ここまで考えてきたような金融構造的リスクが一部で現実化したとしても、中長期のAI半導体需要そのものが蒸発することはないだろう。この需要の約7割はハイパースケーラーによるものとされるからだ。また、2000年代初頭のITバブル崩壊後のインターネットがそうであったように、大きな痛みを伴う調整を経た後に真に持続可能なAIインフラの再構築が実現するかもしれない。

MEMSに長く係わっている者なら誰でも知っているLucent Technologiesのマイクロミラーアレイ。光クロスコネクト“WaveStar LambdaRouter”に使われた。これは2000年前後のITバブルの最中に注目を集めたが、ベンダーファイナンスに傾倒した同社は行き詰まり、ITバブルの熱狂と崩壊を象徴するMEMSとなった。

最新の大規模AIデータセンターは消費電力100 MW超に達する。これは日本最大の一般水力発電所である奥只見発電所の平均出力120~150 MWに匹敵する規模だ。そこで電力系統制約や受電規制が話題になるが、これらはNeocloudの破綻に繋がりかねない。電力効率の高いAIサーバーへの更新が加速するからだ。
主要なNeocloud(CoreWeave、Lambda等)は投資ファンド等からの資産担保融資でGPUを調達し、AI企業(OpenAI、Anthropic等)やハイパースケーラー(Google、Microsoft、Amazon等)に3〜4年のTake-or-Pay契約で貸し出すビジネスモデルを採っている。しかし、電力効率に優れた新型機への世代交代が急激に進むと、担保である保有AIサーバーの資産価値が想定以上のペースで下落してしまう恐れがある。つまり、AI半導体の急速な技術革新が担保価値を毀損させるリスク要因の1つになりうる。
保有AIサーバーの担保割れが生じた際、巨額の負債を抱えるNeocloudが追加担保に応じられなければ、破綻に追い込まれる懸念がある。さらに、減価償却を4〜6年と長めに設定しているのに対し、長期利用契約は3〜4年で終了することが多いのも懸念材料だろう。契約終了後、電力効率で劣る旧型機のレンタル単価は急落するかもしれないからだ。
仮にNeocloudが破綻すれば、NVIDIAも無傷では済まないはずだ。出資持分の減損に加え、担保だったGPUが中古市場へ投げ売られると新品価格が急落しかねない。さらに、GPUの販路が大手ハイパースケーラーに絞られることで、価格交渉力が弱まる可能性もある。直接の損失を被るのは融資元の投資ファンドに出資する年金基金や生命保険会社であり、最終的には一般市民なのだが…
NVIDIAもこのシナリオは避けたいはずだ。一方、計算資源を長期契約したAI企業にとっても既存AIサーバーの急速な劣後は避けたいところだろう。高値で長期契約した計算資源を使い切る前に、最新機を安価に借りた新興勢力に逆転されかねないからだ。AI半導体の発展はAI企業にとって事業のドライバーであるものの、皮肉にも既存ハードウェアの急激な陳腐化によって自社の巨額投資が回収不能になるリスクにもなりうる。
安全規制を主導するAI企業が「人類の危機」を唱える裏には、巨額投資の回収期間を稼ぎ、長期契約した計算機インフラの陳腐化を防ぐ狙いもあるのではないかと邪推する。さらに、AIの安全規制は後発企業の参入を阻む障壁の1つにもなりうる。一方、AIチップの内製化を強化するハイパースケーラーと競合するNVIDIAにとっては、減収によって開発原資の確保を難しくするようなAI規制は受け入れ難い。
この構図において、相対的に有利な立場にいるのはハイパースケーラーかもしれない。彼らにとってNeocloudは需要急増時の一時的な外部調整弁、あるいはオフバランスシートの計算資源という側面が強く、本業のキャッシュ創出力も圧倒的だ。GPUの価格が落ち着けばNVIDIAへの交渉力が増し、投げ売りされたデータセンター資産を安値で取得する余力も十分にありそうだ。
ここまで考えてきたような金融構造的リスクが一部で現実化したとしても、中長期のAI半導体需要そのものが蒸発することはないだろう。この需要の約7割はハイパースケーラーによるものとされるからだ。また、2000年代初頭のITバブル崩壊後のインターネットがそうであったように、大きな痛みを伴う調整を経た後に真に持続可能なAIインフラの再構築が実現するかもしれない。
奥只見ダムは小説の舞台になった。1つは三島由紀夫の「沈める瀧」、もう1つは真保裕一の「ホワイトアウト」。後者では「奥遠和ダム」となっていて、映画撮影には黒部ダムが使われた。主人公の富樫が奥遠和発電所の放水路を流されて命からがら辿り着くのが「大白ダム」で、実際はこの写真の大鳥ダム。

最新の大規模AIデータセンターは消費電力100 MW超に達する。これは日本最大の一般水力発電所である奥只見発電所の平均出力120~150 MWに匹敵する規模だ。そこで電力系統制約や受電規制が話題になるが、これらはNeocloudの破綻に繋がりかねない。電力効率の高いAIサーバーへの更新が加速するからだ。
主要なNeocloud(CoreWeave、Lambda等)は投資ファンド等からの資産担保融資でGPUを調達し、AI企業(OpenAI、Anthropic等)やハイパースケーラー(Google、Microsoft、Amazon等)に3〜4年のTake-or-Pay契約で貸し出すビジネスモデルを採っている。しかし、電力効率に優れた新型機への世代交代が急激に進むと、担保である保有AIサーバーの資産価値が想定以上のペースで下落してしまう恐れがある。つまり、AI半導体の急速な技術革新が担保価値を毀損させるリスク要因の1つになりうる。
保有AIサーバーの担保割れが生じた際、巨額の負債を抱えるNeocloudが追加担保に応じられなければ、破綻に追い込まれる懸念がある。さらに、減価償却を4〜6年と長めに設定しているのに対し、長期利用契約は3〜4年で終了することが多いのも懸念材料だろう。契約終了後、電力効率で劣る旧型機のレンタル単価は急落するかもしれないからだ。
仮にNeocloudが破綻すれば、NVIDIAも無傷では済まないはずだ。出資持分の減損に加え、担保だったGPUが中古市場へ投げ売られると新品価格が急落しかねない。さらに、GPUの販路が大手ハイパースケーラーに絞られることで、価格交渉力が弱まる可能性もある。直接の損失を被るのは融資元の投資ファンドに出資する年金基金や生命保険会社であり、最終的には一般市民なのだが…
NVIDIAもこのシナリオは避けたいはずだ。一方、計算資源を長期契約したAI企業にとっても既存AIサーバーの急速な劣後は避けたいところだろう。高値で長期契約した計算資源を使い切る前に、最新機を安価に借りた新興勢力に逆転されかねないからだ。AI半導体の発展はAI企業にとって事業のドライバーであるものの、皮肉にも既存ハードウェアの急激な陳腐化によって自社の巨額投資が回収不能になるリスクにもなりうる。
安全規制を主導するAI企業が「人類の危機」を唱える裏には、巨額投資の回収期間を稼ぎ、長期契約した計算機インフラの陳腐化を防ぐ狙いもあるのではないかと邪推する。さらに、AIの安全規制は後発企業の参入を阻む障壁の1つにもなりうる。一方、AIチップの内製化を強化するハイパースケーラーと競合するNVIDIAにとっては、減収によって開発原資の確保を難しくするようなAI規制は受け入れ難い。
この構図において、相対的に有利な立場にいるのはハイパースケーラーかもしれない。彼らにとってNeocloudは需要急増時の一時的な外部調整弁、あるいはオフバランスシートの計算資源という側面が強く、本業のキャッシュ創出力も圧倒的だ。GPUの価格が落ち着けばNVIDIAへの交渉力が増し、投げ売りされたデータセンター資産を安値で取得する余力も十分にありそうだ。
ここまで考えてきたような金融構造的リスクが一部で現実化したとしても、中長期のAI半導体需要そのものが蒸発することはないだろう。この需要の約7割はハイパースケーラーによるものとされるからだ。また、2000年代初頭のITバブル崩壊後のインターネットがそうであったように、大きな痛みを伴う調整を経た後に真に持続可能なAIインフラの再構築が実現するかもしれない。
最新の大規模AIデータセンターは消費電力100 MW超に達する。これは日本最大の一般水力発電所である奥只見発電所の平均出力120~150 MWに匹敵する規模だ。そこで電力系統制約や受電規制が話題になるが、これらはNeocloudの破綻に繋がりかねない。電力効率の高いAIサーバーへの更新が加速するからだ。
主要なNeocloud(CoreWeave、Lambda等)は投資ファンド等からの資産担保融資でGPUを調達し、AI企業(OpenAI、Anthropic等)やハイパースケーラー(Google、Microsoft、Amazon等)に3〜4年のTake-or-Pay契約で貸し出すビジネスモデルを採っている。しかし、電力効率に優れた新型機への世代交代が急激に進むと、担保である保有AIサーバーの資産価値が想定以上のペースで下落してしまう恐れがある。つまり、AI半導体の急速な技術革新が担保価値を毀損させるリスク要因の1つになりうる。
保有AIサーバーの担保割れが生じた際、巨額の負債を抱えるNeocloudが追加担保に応じられなければ、破綻に追い込まれる懸念がある。さらに、減価償却を4〜6年と長めに設定しているのに対し、長期利用契約は3〜4年で終了することが多いのも懸念材料だろう。契約終了後、電力効率で劣る旧型機のレンタル単価は急落するかもしれないからだ。
仮にNeocloudが破綻すれば、NVIDIAも無傷では済まないはずだ。出資持分の減損に加え、担保だったGPUが中古市場へ投げ売られると新品価格が急落しかねない。さらに、GPUの販路が大手ハイパースケーラーに絞られることで、価格交渉力が弱まる可能性もある。直接の損失を被るのは融資元の投資ファンドに出資する年金基金や生命保険会社であり、最終的には一般市民なのだが…
NVIDIAもこのシナリオは避けたいはずだ。一方、計算資源を長期契約したAI企業にとっても既存AIサーバーの急速な劣後は避けたいところだろう。高値で長期契約した計算資源を使い切る前に、最新機を安価に借りた新興勢力に逆転されかねないからだ。AI半導体の発展はAI企業にとって事業のドライバーであるものの、皮肉にも既存ハードウェアの急激な陳腐化によって自社の巨額投資が回収不能になるリスクにもなりうる。
安全規制を主導するAI企業が「人類の危機」を唱える裏には、巨額投資の回収期間を稼ぎ、長期契約した計算機インフラの陳腐化を防ぐ狙いもあるのではないかと邪推する。さらに、AIの安全規制は後発企業の参入を阻む障壁の1つにもなりうる。一方、AIチップの内製化を強化するハイパースケーラーと競合するNVIDIAにとっては、減収によって開発原資の確保を難しくするようなAI規制は受け入れ難い。
この構図において、相対的に有利な立場にいるのはハイパースケーラーかもしれない。彼らにとってNeocloudは需要急増時の一時的な外部調整弁、あるいはオフバランスシートの計算資源という側面が強く、本業のキャッシュ創出力も圧倒的だ。GPUの価格が落ち着けばNVIDIAへの交渉力が増し、投げ売りされたデータセンター資産を安値で取得する余力も十分にありそうだ。
ここまで考えてきたような金融構造的リスクが一部で現実化したとしても、中長期のAI半導体需要そのものが蒸発することはないだろう。この需要の約7割はハイパースケーラーによるものとされるからだ。また、2000年代初頭のITバブル崩壊後のインターネットがそうであったように、大きな痛みを伴う調整を経た後に真に持続可能なAIインフラの再構築が実現するかもしれない。
元TI・副社長の石川明さんが1996年に創業したBall Semiconductorはテキサス州アレン市に本社を置いていた。私は20余年前に訪問したことがある。この図に示す球体加速度センサーはSiボールを石膏シェルの中で静電浮上させて3軸加速度を検出する。直径1 mmのSiボールは溶融Siを高所から落下させて作る。

サンケン電気の源流は戦前の五大電力会社の1つ・東邦電力が設立した東邦産業研究所です。「サンケン」は「産研」なのです。一方、東邦電力の子会社だった電気興業所の大垣工場は後にイビデンの河間工場になり、ここで初めて生産されたプラスチックICパッケージ基板の事業がイビデンの発展の起点です。


「日出」は「ひじ」と読む。別府湾の北に広がる町だ。1973年、日本TIの日出工場が稼働した。工場長は石川明さんだった。この工場は2013年に閉鎖したが、その建物は今もあり、中庭の「山神社の森」も健在だ。また、今も日本TIの日出パッケージング・センターがあり、日出ハイテックに同居している。


SiO2膜の色彩と膜厚の関係。SiO2膜表面とSi表面の間で光が干渉して膜厚に応じた様々な干渉色が現れるので、測らずとも膜厚の見当が付く。以前、自社の汎用PECVD装置で付けたSiO2膜が「見事に」グラデーション=ムラになっている写真をXに公開して上司に睨まれた半導体装置メーカーの人がいたような…


MEMSプローブカードで造形が美しいものは、少し古いが、FormFactorの“BladeRunner”だろう。当時、どうやって作るのだろうと不思議に思った。犠牲基板上に先端部分をモールドめっきで形成し、そこにボンディングワイヤを付けてうまく曲げ、めっきで補強してから実装基板に接合し、先端部分をリリース。

日本マイクロニクス(MJC)が絶好調なわけだ。同社の売上高の約半分がサムスン電気向け、約2割がマイクロンテクノロジー向け。そして、両社とも直近の四半期業績で売上高も営業利益も過去最高。MJCは青森第二工場を竣工させていたが、この好機にこの工場にMEMSプローブカードの製造装置を導入する。

Technoprobe(伊)はMEMSプローブカードに特に強い。MEMSプローブカードの旺盛な需要に応えるためTechnoprobeは約4千㎡の新工場“TPI8”を急いで建設する。1億7千万ユーロを投資し、来年には立ち上げる。その建設地は2021年に竣工した“TPI5”の斜め裏にあり、この一画には本社と他の施設も集積している。

NVIDIAはAI半導体のテスト能力を2026年から2027年にかけて倍増させる。同社へのMEMSプローブカードのサプライヤーは第1にTechnoprobe、第2にFormfactorだ。おそらくそのためTechnoprobeは売上高を急伸させていて、絶対王者だったFormfactorを追い越す勢い。HBM・DRAMの需要増に乗ってMJCも絶好調だ。

SK hynixのHBMではメモリダイの積層隙間にアンダーフィルがコンプレッションモールディングによってまとめて充填される。そのための特別なアンダーフィル、すなわちMUF(Molded Underfill)はナミックスがSK hynixと共同開発し、SK hynixに独占供給している。その契約更新が近いと噂されている。

SLTの時代、IBMは半導体素子が載ったセラミック小片をCuボールと半田で実装した。しかし、Cuボールの高さ合わせが困難で接続点を増やすのは難しい。そこで登場したのがC4だ。Cuボールを排し、溶融半田の濡れ領域をUBMで限定し、表面張力で半導体チップ下の隙間を保持。これがControlled Collapse。

C4(Controlled Collapse Chip Connection)とアンダーフィルによる実装技術は、バンプが直径10 μm強まで微細化し、アンダーフィルがMUF(Molded Underfill)に替わり、SK hynixのHBMの積層技術に繋がっています。C4が開発されたのは1960年代、IBMにおいて。そこから脈々と技術が繋がっているのです。

東芝の0.85インチHDDの部品実装面積は極めて小さい。実装基板の真ん中にスピンドルモーター等を納める大穴がある。そこで、LSIベアチップをC4とアンダーフィルによって高密度実装。この方法は1990年代末に普及し始めた新しい技術だった。この論文の第一著者は“T-CHIPS”の幹事の1人の八甫谷明彦教授。

