

🌍 港科大|腾讯阿里 10 年 PM|持续写 AI 时代产品经理怎么干活、怎么做AI产品 💻 一线做AI产品|内容创作者
Joined July 2025
- Tweets1.7K
- Following360
- Followers3K
- Likes3.1K




卧槽,腾讯这是咋了呀😭
我还在车上啊


#大毛腿拆AI 腾讯搞AI革命,中层和基层未必买账
腾讯总办最近的内部讲话,要把 AI 视为生死存亡的问题,推动组织扁平化,打破部门壁垒,让基层有能力的人获得更多机会。
但是,每个人都有自己的小心思
1. 高层:我不改变,就可能失去整个公司
高层考虑的是公司未来五年、十年的生存问题,所以宁愿牺牲部分短期利益,也要推动组织变革。
等到现有业务真的被冲击、利润开始下滑,再去推动组织变革,可能已经来不及了。
所以在他们眼里,AI 是一场必须提前投入的战略战争。
2、中层:公司再创业,但我为什么要重新开始?
原本业务稳定、收入不错、手里还有团队和资源。
AI 变革可能意味着管理权力缩水、既有利益受损,创新成功收益未必归自己,失败却可能影响绩效和职位。
对部分中层来说,维持现状反而是更理性的选择。
3. 基层:有人看到了机会,有人看到了风险
有能力、有想法的人,可能借助 AI 突破组织层级的限制,获得更多机会;依赖重复性工作的人,则担心被替代。
还有大量普通员工,只想稳定工作、照顾家庭,并不想重新创业。
上述现象因为:
AI 创造的收益,和变革需要付出的代价,并不是平均分配的。
公司获得效率和利润,部分中层可能失去权力,少数员工获得机会,另一些员工却可能失去工作。
员工没有决策权和收益,却要承担创业者的压力与风险。
凭什么要求所有人都像创业者一样拼命?
———————————————
关注「奔跑的大毛腿」,一起拆解 AI 产品技术与商业逻辑
1
4
207
#大毛腿拆AI 腾讯搞AI革命,中层和基层未必买账
腾讯总办最近的内部讲话,要把 AI 视为生死存亡的问题,推动组织扁平化,打破部门壁垒,让基层有能力的人获得更多机会。
但是,每个人都有自己的小心思
1. 高层:我不改变,就可能失去整个公司
高层考虑的是公司未来五年、十年的生存问题,所以宁愿牺牲部分短期利益,也要推动组织变革。
等到现有业务真的被冲击、利润开始下滑,再去推动组织变革,可能已经来不及了。
所以在他们眼里,AI 是一场必须提前投入的战略战争。
2、中层:公司再创业,但我为什么要重新开始?
原本业务稳定、收入不错、手里还有团队和资源。
AI 变革可能意味着管理权力缩水、既有利益受损,创新成功收益未必归自己,失败却可能影响绩效和职位。
对部分中层来说,维持现状反而是更理性的选择。
3. 基层:有人看到了机会,有人看到了风险
有能力、有想法的人,可能借助 AI 突破组织层级的限制,获得更多机会;依赖重复性工作的人,则担心被替代。
还有大量普通员工,只想稳定工作、照顾家庭,并不想重新创业。
上述现象因为:
AI 创造的收益,和变革需要付出的代价,并不是平均分配的。
公司获得效率和利润,部分中层可能失去权力,少数员工获得机会,另一些员工却可能失去工作。
员工没有决策权和收益,却要承担创业者的压力与风险。
凭什么要求所有人都像创业者一样拼命?
———————————————
关注「奔跑的大毛腿」,一起拆解 AI 产品技术与商业逻辑


#大毛腿拆AI 用户每天刷 3 小时,红果的增长秘籍
红果人均活跃 166 分钟/天,超过抖音。前 50 的 App 中,字节系已占据 41.8% 的总时长份额。
作为PM和内容创作者,我很关心:
1. 字节怎么把一套成熟的增长方法,不断复制到新的行业?
2. 当行业开始围绕数据和效率运转,会发生什么?
01 字节的效率机器
红果进入短剧行业并不算早,免费模式也早就在番茄小说上得到过验证。
但字节已经积累了一整套成熟的能力:
①获客: 借助抖音等产品的流量优势,降低新产品的获客成本。
②供给: 通过保底、分账吸引创作者,快速解决内容冷启动的问题。
③分发: 依靠成熟的推荐算法,让内容更精准地匹配用户需求。
④变现: 复用广告商业化能力,用广告收入支撑用户免费观看和创作者分账。
几个环节串起来,就形成了一套能够持续运转的商业模式。
团队同时推出多款底层模式相似、定位略有差异的 App,测试不同的市场机会。
红果,最初只是番茄团队孵化的众多“小包”产品之一。
跑通了,就继续投入资源,把规模做大。
字节的优势来自多个环节的长期积累,以及这些能力在不同产品之间的复用。
一款爆款产品可能有运气成分,但能持续做出爆款,靠的就是组织能力了。
02 创作者越来越焦虑
红果的另一个特点,是把内容生产变成了一套高度数据驱动的系统。
短剧制作周期短、试错成本低。什么题材受欢迎、什么剧情能留住用户,平台可以快速获得反馈,再影响下一轮内容生产。
但当所有人都盯着同一套数据,问题就来了。
什么题材火,就拍什么;哪种剧情受欢迎,就反复复制。短期成功的确定性提高了,内容却可能越来越同质化。
而且,数据结果本身存在很大的不确定性。
一篇文章、一部短剧能不能爆,受到内容质量、发布时间、竞争环境、推荐机制等多种因素影响。
数据原本是辅助决策的工具,最后却可能变成所有人追逐的目标,并反过来影响内容。
平台掌握着流量分发、评价标准和收益规则,数据也让平台对整个生态拥有了更强的控制力。
比如,红果早期通过保底吸引制作方,等内容供给充足,又开始收紧部分保底补贴。
03 极致效率,然后呢?
今日头条提供资讯,抖音提供短视频,番茄提供小说,红果提供短剧。
不同的产品覆盖不同的内容需求,最终争夺的都是用户有限的时间。
红果对广告体验做了大量测试。用户可能不愿意为了看下一集等待半分钟,却能够接受几秒钟的短广告。
字节对效率的追求,已经深入到了产品的每个环节。
我们一直强调数据驱动,但有没有想过,数据究竟在引导我们做什么?
平台奖励观看时长,内容就会不断优化怎么留住用户。
自媒体作者只盯着曝光量,也很容易慢慢变成一个追热点的人。
久而久之,评价标准就会影响所有参与者的行为。
平台希望用户花更多时间,与用户希望更好地利用自己的时间,这两个目标并不总是一致。
读完红果的故事,我对字节这套效率机器确实很佩服。
但作为产品经理,也应该想清楚自己究竟要制定什么产品指标。
你选择用什么指标衡量成功,最终就会做出什么样的产品。
———————————————
关注「奔跑的大毛腿」,一起拆解 AI 产品技术与商业逻辑


2
5
370

#大毛腿拆AI 黄仁勋不在,英伟达还能统治 AI 时代吗?
11 月 12 日,黄仁勋突然辞去英伟达 CEO 职务。
但我认为,黄仁勋离开,不会立即动摇英伟达的统治地位。
英伟达的护城河,不仅是 GPU 性能,还有围绕 GPU 建立的整套计算生态。
1. 英伟达的护城河,到底是什么?
很多人认为是GPU、CUDA,实际上远不止如此。
• 硬件层: GPU、显存、NVLink 高速互联等技术领先,强大的计算和集群能力。
• 软件层: CUDA、TensorRT 等工具,以及对主流 AI 框架的深度优化。
• 生态层: 大量开发者、成熟的开发工具,以及客户已经建立的训练、推理和运维体系。
假设今天某家厂商推出一款性能相近、价格便宜 30% 的 AI 加速卡,客户就会买吗?
真不一定。
原来的代码、算子、模型、推理框架需要重新适配,性能和稳定性需要重新验证,开发人员也需要重新学习。
这才是英伟达最难被替代的地方。
2. 为什么国产算力需要政策推动?
对于已经使用英伟达技术栈的客户,如果单纯从市场竞争角度考虑,为什么要换国产算力?
芯片价格可能便宜,但加上迁移、适配、调优和运维成本,综合性价比未必有优势。
所以,国产算力推广不能完全依靠市场自发选择。
这也是为什么国家要通过补贴、国产采购项目、国产算力中心等政策手段推动国产算力发展。
背后的逻辑并不复杂:
企业追求当下的综合性价比,国家需要考虑长期的供应链安全和技术自主可控。
政策可以先创造市场需求,让更多客户真正使用国产算力,进而带动软件适配、开发工具和生态成熟。
但是,政策可以推动采购,却不能保证客户愿意持续使用。
国产算力最终能否成功,还是要看能否真正降低使用成本、改善开发体验,而不是只看一年卖出去多少张卡。
3. 英伟达未来会被替代吗?
短期很难,但长期并非不可替代。
Google TPU、AWS Trainium、AMD GPU,以及国内的华为昇腾等,都在尝试走出自己的技术路线。
随着 AI 推理需求增长,不同业务对性能、延迟和成本的要求正在分化,专用芯片可能在部分场景更有优势。
如果软件框架和编译器还能进一步屏蔽底层硬件差异,让客户更容易切换计算平台,英伟达的生态壁垒就可能逐渐减弱。
所以,黄仁勋离开并不会让英伟达的护城河突然消失。
可能撼动其地位的,是有一天客户发现:
换掉英伟达,已经不再是一件成本高昂、风险巨大的事情。
———————————————
关注「奔跑的大毛腿」,一起拆解 AI 产品技术与商业逻辑

#大毛腿拆AI AI时代,产品经理成了香饽饽🫣
Lenny 刚发了第五份科技就业报告,结论:
1、PM 开放岗位比 2023 年初多了 56%,涨得比工程(+43%)、数据(+18%)都快
2、工程岗涨不动了,年增速从 29% 掉到 15%,再到 2.5%
3、FDE(前线部署工程师)一年涨了 4.6 倍,爆火
4、设计岗跌到历史最低❄️,前端岗一年少了 51%
从中我们能发现
1️⃣ 写代码门槛低了,“做什么、做到什么程度算好”变贵了,产品判断力成了稀缺品
2️⃣ FDE 暴涨,说明 AI 的难点在最后一公里:把模型接进客户真实的流程、数据和系统里
3️⃣ 前端、移动端、设计一起缩,用户界面层正在被 AI 生成,同时,使用者也变成与 Agent 直接对话
4️⃣ 但别读成“PM 好混了”,职责也宽了,原型、评测、部署都可能落到你身上
这套技术判断力怎么补?
我昨天长文从 GPU 一路讲到 Agent,配合着看👇

3
7
864
#大毛腿拆AI 人形机器人有未来么?
97%中国造、87%中国买,80%在做秀,只有3%在打工
据 SAG 的报告,2026 年第三季度,全球人形机器人出货 16500 台,市场其实很小,全年也就是几万台的量级。
机器人买回去,到底在干什么?
和想象完全不一样:它们绝大多数并没有在替人打工,而是在做秀、陪练和招商:
1. 近 80% 的机器人还在“走秀”和“搞科研”
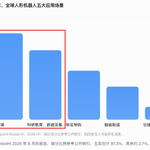
Counterpoint 2026上半年数据显示:文娱商演(33.6%)、科研与数据采集(27%)、导览导购(19%)占据了绝对大头。而真正进工厂的智能制造和仓储物流,加起来才 18%——且多为试点测试。
2. 头部玩家的尴尬:进厂打工的不足 3%
拿宇树科技的数据来看,前三季度科研教育(73.6%)+ 商业消费(17.39%)占了绝大部分。真正落地制造、巡检、物流的收入,实际只有 2.6%。
3. 机器人在“左手倒右手”
更有意思的是,为了训练机器人干活,各地狂建具身智能数据中心,买机器人来采集“抓取、搬运”的数据。机器人产业本身,居然成了自己最大的客户。
💡 我的思考:
供应链和产能领先,不等于生产力领先。
今天的繁荣很大程度建立在“科研投入、政府示范和商业噱头”上。但这不代表它创造了真正的经济价值。
人形机器人行业下半场,重点看:进了多少岗位、需不需要人工辅助、以及客户愿不愿意复购。
以及,一个最重要的问题,还需要从业者回答:
机器人为什么一定要是人形呢?
————————————————————————————
关注「奔跑的大毛腿」,一起拆解 AI 产品技术与商业逻辑

2
2
764
大厂绞肉机,一点不夸张
我在阿里、腾讯都待过,“瞎折腾”这绝对是大厂的通病
大领导没有耐心,就给团队一个Q,顶多半年的时间
小领导急于出成绩,就会急功近利,瞎折腾
产品跑不出来,就滚蛋
频繁换人,恶性循环
问题是,多少产品能在半年时间从无到有,打磨好上线,并且还能赚钱呢?

作为阿里云的前员工,看到Qwen这么不争气,也还是有点失落的
其实阿里云的GPU资源也不少,人才也不少
但是阿里云不管是Qwen模型系列,还是千问app这种ToC的产品,一直都差点意思
我在阿里云待的几年,组织架构,CEO,CTO这些对方向影响比较大的事情跟人,变化都很快,其实高层对于AI,只知道要All in AI,却对现在AI这个日新月异的领域,没有以前那种判断力了。
再就是各种部门之间的掣肘,互相制约,最初的资源是没有集中到一起的。
Google当年在AI上意识到问题后,也知道把Deep Mind跟 Google Brain合并,集中资源把gemini也做出来了。
阿里云做了什么呢?一系列混乱的产品,跟模糊不清的定位。Qwen在阿里云下面,不仅承担模型的研发,还要承担Qwen的产品化,没错,就是千问产品,同时还要考虑如何带动云资源消耗。其他部门都要应对云资源消耗,token消耗的考核目标。
问题是你模型都还没做出来足够好的效果,就开始考核他的产出,考核如何在云资源中去体现,还要同时考核千问产品化。这些虽然是不同的部门,不同的团队小组在负责。但是千问产品这边的一些体验,必然会反过来影响qwen的模型迭代,同时云资源消耗的压力也是一样的。
这还只是qwen的问题,还有各种其他的,语音模型更是一堆混乱的内部竞品。百炼这个产品也是个奇葩,从一个独立想要做模型调用平台的产品做出来,变成什么都想要往里塞,产品页面越来越用不懂。
我现在看到更多的,是一个大公司,在想要证明自己是一家头部互联网公司,而病急乱投医,什么都想要做,不想在技术上落后,又想要赚钱稳住股价,又要解决内部人员多,部门之间的利益冲突,积重难返
1
2
624
#大毛腿拆AI 阿里云Token Plan额度暴涨75%,卖Token已经开始赚钱了?
11月9日,阿里云宣布调整 Token Plan:算下来,单位 Credits 售价整体下降了约43%。
为什么敢这么降价?难道大模型推理已经很赚钱了?
查了一下最新的财报和行业数据,发现事情比想象中有意思。
先看两个关键数据:
① 阿里巴巴2026年4—6月财报:
AI云与算力服务收入484亿元,经调整EBITA盈利56亿元。这个包含云基础设施等业务,但整体是盈利的。
同期,AI实验室与应用业务经调整EBITA亏损139亿元,大模型研发和千问APP部分亏损扩大。
②《晚点 LatePost》10月底报道:
字节跳动火山引擎MaaS业务,上半年收入约48亿元,毛利率超过55%。自研豆包模型及第三方模型推理服务均已实现正毛利。
由此可见,两种业务正在分化:
1、卖Token的MaaS业务,已经有不错的毛利
2、做模型研发和C端AI应用,依然需要承担巨额投入
为什么可以大幅提升额度?我认为有三个原因。
1. 推理成本在下降
模型量化、推理引擎优化、批处理、算力利用率提升,都在降低单位Token的推理成本。
2. 额度提升75%,不代表成本增加75%。
Token Plan本质上是订阅制,Credits也不等于原始Token。
很多用户根本用不完额度,未使用额度又不能结转。只要实际消耗没有同比例增加,平台的成本就不会同比例增加。
3. 抢占开发者入口,比短期利润更重要
阿里云争夺的是开发者的使用习惯,以及未来企业API和云服务的商业机会。
接下来,我更关注三个指标:
Token价格能否继续下降?MaaS收入能否持续增长?毛利率能否保持?
三个指标的逐步改善,意味着大模型推理正在从战略投入,逐步变成一门可持续的生意。

4
5
550


#产品观察
平台想让你多刷一小时,但这是你想要的吗?
最近,欧盟对 TikTok 的推荐算法出手了。
欧盟认为,TikTok 的推荐系统存在“兔子洞效应”,可能让用户不断陷入同一类内容,甚至难以自拔。
这件事背后,其实藏着一个更值得讨论的问题:
平台的商业目标,与用户的长期利益相冲突,我们要怎么办?
一、算法懂你,但未必对你好
假设你最近有些身材焦虑,偶然刷到一个减肥视频,多看了几秒。
算法捕捉到这个信号,开始推荐更多减肥内容,接着是身材比较、极端节食、容貌焦虑……
你越看,算法越推荐;越推荐,你可能越焦虑。
这就是所谓的“兔子洞效应”。
它和信息茧房不完全一样。信息茧房让你越看越窄,兔子洞效应则让你沿着某一类内容越陷越深。
问题在于,算法能识别你的行为,却很难理解行为背后的真实需求。
你反复看失业焦虑的视频,可能不是因为喜欢,而是因为害怕。
但算法可能把这种焦虑当成兴趣,不断强化。
二、为什么平台很难主动改变?
答案很简单:商业利益。
大多数内容平台依赖广告变现,而用户停留时间越长,通常意味着更多广告展示机会。
所以,推荐算法的重要优化指标往往是点击率、完播率、观看时长和留存率。
假设新算法让用户每天多刷了 15 分钟。
从产品数据看,这是一次成功的优化。
但对用户来说呢?
本来只想刷十分钟放松一下,结果两个小时过去了。放下手机,反而觉得浪费了时间。
平台获得了更多流量,用户却未必获得了更多价值。
这就是问题的根源:
平台追求的是容易量化的短期行为指标,而用户真正需要的,可能是很难衡量的长期价值。
但当观看时长成为核心目标时,平台就很难不去争夺用户更多的注意力。
三、欧盟这次监管,触及了什么?
我觉得最值得关注的,是监管思路的变化。
过去,内容监管主要关注:这条内容是否违法、是否应该删除。
现在,欧盟开始追问:
即使内容本身合法,平台通过算法反复推荐,造成潜在伤害,是否也需要承担责任?
这意味着监管开始深入推荐算法的设计,而不仅仅是内容审核。
四、我们该怎么办?
我不认为应该完全拒绝推荐算法。
它确实帮我们降低了信息获取成本,也让很多小众内容找到了受众。
但作为用户,我们至少应该保留三个习惯:
1、主动获取信息:不要依赖推荐流,多搜索、多看不同来源。
2、管理自己的标签:遇到制造焦虑、愤怒的内容,及时划走,用行动反馈给算法。
3、掌握退出的主动权:明确自己为什么打开 App,以及准备什么时候离开。
一个让你停不下来的产品,不一定是好产品。
平台想让你多刷一小时,但这一小时值不值得,最终应该由你决定。

真的,AI圈的人才太多了
AI圈谱效果太惊艳了!
对做账号很有帮助,找同行也很方便
从数据范围,到归纳的准确性,到关系的挖掘,非常厉害👍


前几天发了各个城市AI 名单,很多朋友说有帮助
蹬了两天,用掉了 @bot Ultra+几百刀 X API,做出目前最全的 X 华语 AI 社交图谱:
· 1700+ 账号(博主/从业者/官号)
· 3.6 万互关
· 按地区、类型、方向筛选
如果有帮助可以转发支持 🙏
💫 aimap.social
Build marketing like a product
2
5
528
Agent,它到底怎么工作的?
为了搞懂,我从零做了一个 Min Agent,已经开源
它是一个专门用于学习 Agent 工作原理的可视化观察台
你可以给它一个任务,然后逐轮观察:
1、上下文: 模型当前知道什么?
2、模型决策: 为什么选择这个动作?
3、工具调用: 实际执行了什么?
4、观察反馈: 执行结果如何影响下一轮?
5、权限控制: 操作被拒绝后会发生什么?
6、完成验证: 凭什么判断任务已经完成?
每一步都有真实运行记录,可以查看和回放。
支持本地运行,提供 Fake 模拟模式和 DeepSeek 真实模型模式。
不需要先读懂源码,也能直观理解 Agent Loop 的工作机制。
GitHub 开源地址:
github.com/JinweiX/min-agent


