

分享一些好用优雅的 AI 、工作流和创作方式,边学边做,前阿里coder, Al and tech Educator, LearnPrompt founder
Earth
Joined July 2023
- Tweets6.2K
- Following1.3K
- Followers25.1K
- Likes10.8K


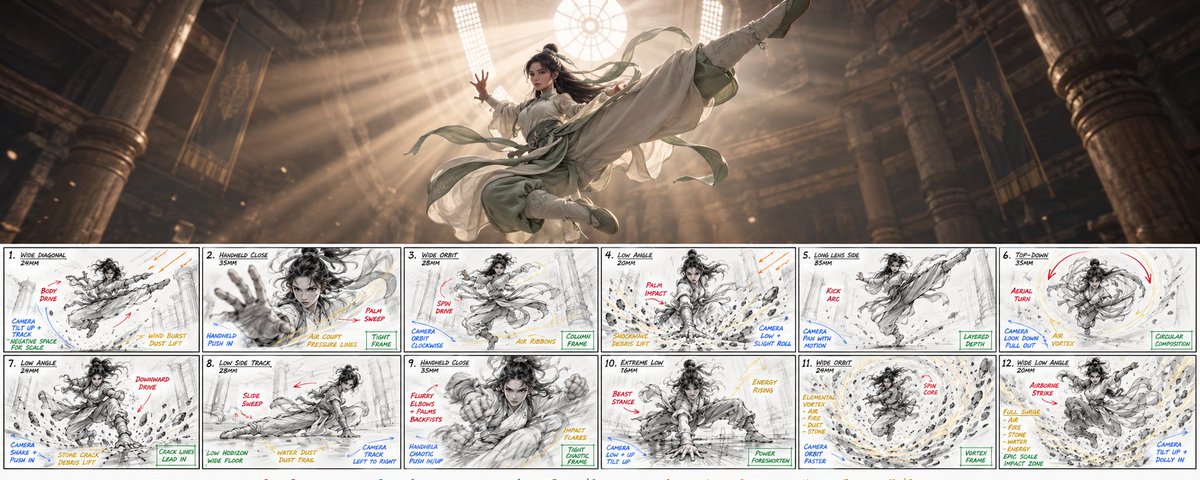


分享6个新提示语去掉DeepSeek新模型和codex的AI味
最近在琢磨怎么用DeepSeek做出类Claude Opus 5.5的代码动画。这类动画可以理解成让模型用代码规定好画面里的字和图形怎么动,再由程序按这些规则一帧帧生成。跟做网页UI共用不少能力,排版、配色、留白都用得上。
1. 删重复文案
Deepseek喜欢把页面写成说明书,中文大标题上还要顶一行没啥信息的英文小字。
提示语1️⃣
审查当前画面里的全部文字。删掉没有实际信息的口号,标题上方纯装饰的英文小字,以及把标题意思又复述一遍的解释。同一件事只说一次,优先靠位置远近,分组和间距表达关系。做视频时保留必要的重点文字,别把解释设计意图的说明也写进画面。
2. 不要给每段内容加重点框
Deepseek它喜欢给每个数字文字外都套个框,加圆角阴影和彩边。
提示语2️⃣
检查画面里所有的方框,阴影,圆角和彩色边线。把同一组相关的信息放一起,靠位置,间距,对齐和细线讲清楚关系。拿掉为了装饰才加上的层层套框,彩边和重阴影。用来分组,或者提示可以点击、操作的区域,再保留清楚的边界。
3. 指定每种颜色的用途
之前是蓝紫色泛滥,现在是人均渐变半透明了
提示语3️⃣
先给背景,正文,次要说明,重点和状态分配固定的颜色。同一种含义使用同一颜色,删掉没用的装饰色。渐变、半透明和颗粒可以留,但要服务同一种画面风格,不能挡住正文或抢走重点。
4. 统一字号,对齐边角
专门对付页面字忽大忽小,图标跟文字不同高度
提示语4️⃣
把主要字号先收敛到三到四档,多用字的粗细,间距和颜色深浅拉开主次。检查图标与旁边文字看起来是否对齐。按最终显示尺寸检查文字能否轻松读清,不死套12px小字或0.5px细线。动画里的字也要在正常观看尺寸下看得清。
5. 一屏只讲一件事
提示语5️⃣
先明确这一屏或这个镜头最想让人看懂的一件事,再给内容排先后顺序。删掉与当前重点无关的干扰,不要一次铺满。交互网页不常用设置可以点开再看,视频里次要信息可以晚一点出现。
6. 动画&动效设计
提示语6️⃣
逐个检查动态效果是在引导视线,展示变化,推进叙事,还是提供操作反馈。减少没有目的的漂浮,乱弹和机械的逐字蹦出。网页保留必要操作反馈,代码动画保留推动叙事的镜头和图形变化。按内容调整快慢,停顿和缓动,不要给所有动作统一套250ms。
说到这,可以预告我正在做的大剪辑Skill了。已经能用deepseek剪出十分钟的真人口播,配上二十份案例视频和操作录屏。我这周整理出来!
史上最短Personal Agent入门教程!13选1
昨天刚更新了决定Personal Agent好用上限的五个标准,就有人问我有没有更简单的打法,根据能接入app的多少,订阅额度和限制区域来一个综合排名。
所以我来了!
这个排名是按照可接入的APP的多少作为选择性元素,如果是按照可以接入的MCP或者skill的话,现在新冒出来的都不够openclaw跟Hermes强,dots理论上还可以接入codex现有4000个插件,不过现在还没有完全兼容。
参与排名的有meta muse,grok bot,chatgpt dots,gemini spark,hark,Instinct,OpenClaw,Hermes,manus cue,poke,today,千问Go!,灵光2.0
1️⃣ 首先第一轮排名是能接的App数量,
muse(54)>Dots(50)>spark(35)>today(30)>poke(30)> grok bot(20)>cue(15)>Instinct(12)>hark>灵光2.0(10)=千问Go(10)=Herems=OpenClaw
高度重叠的app(超过半数的agent有)Google Workspace,Slack,Notion,github,Microsoft 365,日历和邮件类。
比较特有的是muse的meta生态(facebook,ins,threads这些),还有健康,智能家居和车机(Peloton,Withings,Philips hue,tesla),还还还有Plaid和Shopify的电商类。
spark就是有Google的特色keep和tasks,还有Adobe,以及SeatGeak等很多是我完全没用过的生活类。
Hark有特有的多浏览器并行,做信息收集比grok bot多agent还快点。
today,灵光,千问go就是些我们熟悉的app了,飞书,钉钉,企微,滴答,米家(小米车机),千问go还把阿里系的支付宝淘宝天猫高德菜鸟接进去了。
让我选就是按照自己常用的APP,海外跟国内各选一个,双持手机实现全覆盖。
2️⃣ 我们第二个排名,还要从额度,使用限制,生态兼容来看。既然是要介入生活,我肯定希望一个月30天都不会因为额度而缺失记录了我的健康数据。
Hark(免费,订阅的区别就是额度,不限制功能,ios安卓网页都能用)>Poke(有免费额度)=today(有chrome插件可以复用电脑本机登录态做浏览器自动化)>spark(订阅pro)=grok bot(订阅pro)=openai dots(订阅)>hermes(有免费模型也可以自己配api,愿意折腾的话mcp skill都可以接满)=openclaw>muse(只能美国加拿大用)>千问go,灵光2.0,cue和instinct(这些都要邀请内测)
相信通过我这个史上最短personal agent入门排名,你也能选出来现阶段最适合你的personal agent, 不过生态都在快速发展中我估计一个月后这个排名又会有变化,数量也会有变化,到时候我再来一版。




OpenAI dots给我帮助最大的就是谷歌邮箱了,之前没想到有那么多额外信息被我遗漏掉的。
比方说,
1. 网站服务的流量超额提醒。
2. Google 发来的网站收录问题。部分页面被 Google 选了其他规范网址。它把这条邮件和我正在做的 GoodCase SEO 联系起来,列出了要核查的信息。
4. API 服务的低余额提醒。
5. 创作者平台的付款进度。
等等等等
而且及时性很高,没有mac mini的话也可以把定时任务全丢dots上
然后如果大家想用可视化页面来登录账号的话,可以用下面这个提示语👇
在你的云端浏览器打开这个网站,把安全登录界面交给我;登录后继续指定任务。



录教程最烦的不是录屏,是先把 Chrome 的画面收拾干净,这样才不烧心❤️
所以我做了个免费插件:卡尔画幅。
一键切 4:3、9:16 等六种画幅,点一下藏掉侧栏、Logo,再用你熟悉的录屏软件录。
已上架,欢迎试试,有不好用的地方直接回复我👇
chromewebstore.google.com/de…
顺手也优化了我常用的「飞书文档 → X 长文」Skill。
这次主要补了这些:
• 图片太多时,把相邻图片合成完整、不裁切的拼图
• 清理飞书导出的 Tip 等标记,保留内容和换行
• 补上大视频压缩、GIF 转视频,以及登录状态复用
🔗 github.com/LearnPrompt/x-art…

I'm glad there's a review step. Asking for help writing a character shouldn't turn that character's backstory into facts about me.

NEW GROK BOT!
AI MEMORY TRANSFER!
Your old AI knows you.
Your new one shouldn't have to start from zero. 🧠➡️
Meet Memory Transfer, a @Grok @Bot that brings over what Claude or ChatGPT learned about you, so you don't spend weeks re-explaining yourself.
There are two ways to bring it over:
• Paste one prompt into your old chat and send me the answer.
• Or drop in your full ChatGPT or Claude data export.
The part that matters most is that nothing gets in automatically.
We review every item together, one line at a time. Only what you keep gets saved, and each item is tagged with where it came from and when.
Other AIs' guesses don't become facts, and nothing you've already saved gets overwritten unless you say so.
Switch assistants and keep your context, without the junk.
Try Memory Transfer on Grok Bot today.
x.ai/bot/Ww-RXj-lLqpg_oWqzcc…

能接着存、自动跳过存过的,这俩功能太实在了。传一大包素材,最怕的就是卡在一半,还得自己猜哪些传了哪些没传。

用 AirDrop 传专业设备拍的超大照片和视频(动辄 20GB)一直很痛苦。
更难受的是 iPhone 的“文件”和“相册”之间几乎不互通:在“文件”里解压一个大包,想全部存进相册,没有进度,还经常闪退,存一半都不知道存到哪了。
这两天啵啵自己把它解决了。她完全没写过代码,让 Dots 操控云端电脑写了个 App,拿到她的 Mac 上,用数据线直接装到了自己手机上。没有 Apple 开发者账号,整个 App 只有 66KB。
功能很简单:把超大的 ZIP 解压之后一张一张存进相册,能看到进度,中断了还能接着存,已经存过的会自动跳过。
刚才实测 953 个文件、15.32GB,4 分钟左右全部存完。
以前遇到这种事儿只能忍或者不断自己再试试,现在不会写代码的人也能花两天给自己做个工具了,今年 vibe coding 的发展可以说是真的震撼。


真的没空跟你们这些大水理论、大睡理论、薄肌理论的闹了,现在我提出大AI理论!
🔥大水理论为什么比薄肌理论火?
薄肌还需要练,大水理论是真的直接来瓶水就可以了。大AI理论也吸收了这个顶级优点,不挑订阅,不挑模型,不挑Agent框架,不需要记提示语,主打一个分三阶段给AI对话就可以把模型干活能力拉到极致。
1️⃣第一步,把现在用的模型推理程度拉到最高,选择计划模式,然后把键盘完全丢掉,用语音,图片和视频发信息。
就把AI当成平时跟朋友聊天那样,我跟朋友解释一个梗的时候也不会一个个图一句句话说,都是直接一个视频丢过去让TA看来龙去脉,大部分有多模态能力的AI也能做到。
而且语音输入就最大化降低信息损耗,我不夸张,现在AI语音识别就算没有一些技术词的词典,一次正常的录入也就改1-2次,改完之后还能收录到词典,性价比真的相当高。
这步的核心就一句话,你脑子里那些乱七八糟的想法,不过滤不整理,全部倒给AI。你越懒得打字越不想组织语言,这步效果反而越好。因为高推理模式会把碎片整理成完整计划。打字的时候你反而会下意识精简,信息就在精简的过程里丢了。
2️⃣ 第二步,把模型推理程度改到中档,快速实现干活!
在纯代码实现或者Agent干活的情况下,中档和高档的推理程度在质量上没有拉出太大的差距,速度的提升是相当可观的。
这有一个大前提,就是第一步的需求描述必须足够详细。这个在一个叫Terminal Bench 3.0的基准测试上有过数据验证,详细需求 + 中档推理,和模糊需求 + 高档推理比,前者的完成质量反而更高。
你想想看这其实跟人交接工作一样。一份写得巨详细的PRD交给一个中等水平的程序员,干出来的活大概率比你甩一句「帮我搞个xx」给大牛要靠谱。
3️⃣第三步,把模型推理改到高以上的档位,验证之前干的活!
这步是整个理论的灵魂。中档推理干活快是快,但脑子转得没那么细。就跟赶DDL写代码一样,功能能跑就行,细节先不管。
所以你要把推理调回高档甚至拉满,让AI review自己中档时候干的活。我自己的经验,这一步至少能额外揪出来20%-30%的问题。边界情况没处理,逻辑有漏洞,有更好的实现方式,全都是在这步被捞出来的。而且验证的速度其实很快。审查已有的东西比从零开始写快得多,高推理花在验证上的时间大概只有从头生成的三分之一。
❓这时候就有可能会说,
那我直接全程推理程度拉满不就完了?
说真的我一开始也是这么干的。但全程拉满有两个问题,就算额度完全用不完。一个是慢,真的很慢,你坐那等半天效率反而不如中档快速迭代。另一个是高推理在执行阶段容易想太多,纠结半天选方案A还是方案B,你给它一个明确的计划让它别想直接干,产出反而更稳定。
💡一开始提出这大AI理论本身是想玩梗的,没想到真的做出来这个如此有用的超大杯、中杯、大杯的理论。
有时候有用的东西就是这么朴素。
大AI理论,三步就够了。
