

リサーチや研究開発向けの生成AIエージェント @snorbe_ai を作っています。 https://teapawt.org/t.co/AC4vjFWlLR @deskrex | 著書 かんき出版『知的生産でAIを使いこなす全技法』 https://teapawt.org/t.co/3ZTHROXGlV
Joined January 2018
- Tweets8.2K
- Following388
- Followers2.8K
- Likes20.5K




Itaru Tomita / 冨田到 retweeted

隠してたけど!!!!!!
Modalくん無料プランでも毎月30ドル分のGPUが使えるぞ!!
H100が1時間4ドルくらいで、使った秒数だけ払えばいいぞ!!!!
安い!!!!!!!
Foooooo!
modal.com


GPUの計算時間を、必要な期間だけ売買しやすくする市場にも資金が向かうのでしょうか(axios.com/newsletters/axios-…)。Axiosが11月3日、OrnnのシリーズA調達交渉を報じました。
報道は、3段階に分けた計1億5,000万米ドルを調達中で、Thrive CapitalとGeneral Catalystが主導するという内容。最終段階の評価額が10億米ドルを超える可能性にも触れています。
これは調達完了の発表ではありません。1億5,000万米ドルは調達中の金額で、10億米ドル超は成立した場合の評価額の話です。会社による正式な完了発表、最終条件、資金の具体的な使途は確認できていません。
Ornnの公式サイトでは、GPUの計算能力を必要とする企業と、空いている設備を持つ側をつなぐサービスを提供しています。契約期間は短時間から複数年まで。使わない容量を他の利用者へ回し、取引に基づく価格情報も扱います。
AIモデルを開発する会社に加え、計算資源を確保し、余った分を融通し、価格を把握する仕組みにも事業が広がっています。長期契約で余らせるリスクと、必要なときに不足するリスクをどう減らすか。今回の交渉報道は、その市場を追う材料として見ています。

医師向けAIに、必要に応じて専門医へ相談する仕組みを組み合わせる動きがあります(techinside.com/for-physician…)。トルコのFor Physicianが26万7,200米ドルを受け入れたと、TechInsideが11月3日に報じました。
記事によると、将来の株式転換を予定する借入型の資金調達です。ÜNLÜ & Co、Orhan Mutlu Topal氏、医師の個人投資家が参加。追加募集は続いており、ラウンド全体が完了したという報道ではありません。評価額400万米ドルとの説明もありますが、転換条件や評価額の基準は確認できていません。
製品は、本人確認済みの医師向けに、臨床上の質問への回答や画像の評価、処方検討を支えるAIツールを提供します。希望すれば専門医の意見も別に求められます。
ここは区別が必要です。公式サイトは、AI回答が自動で専門医の承認を受けるわけではなく、専門医への相談は任意と明記しています。最終的な臨床判断は利用する医師が担います。調達のニュースは診療の正確性を証明するものではありません。
資金は地域展開、医師団体との提携、マーケティングに使うと報道されています。AIへの質問と人の専門家への相談を同じ場で扱いながら、誰がどの回答を確認したのかを明確にする。この役割分担にも注目したいです。

AIで書類作成が速くなったら、法律サービスの料金の仕組みも変えられるでしょうか(weekender.com.sg/globenewswi…)。Athenaが11月3日、a16z Speedrun主導の250万米ドルのプレシード調達を発表しました。
商業用不動産の売買や融資に必要な契約書類を、AIエージェントと提携法律事務所の弁護士で扱う会社です。法律事務所へソフトウェアを売るだけでなく、AIを前提に法律サービスそのものを組み立てています。
AIは契約書と取引条件を照合し、矛盾を探し、修正案や顧客への連絡文を作成。過去の取引から顧客の交渉上の希望も参照します。弁護士が内容を確認し、法的判断を行い、顧客へ渡す前に承認します。
サービスを提供するAthena Circleの料金は、作業時間ではなく取引ごとの定額。仕事を速く終えるほど、顧客の待ち時間と提供側の作業負担を一緒に減らせる設計です。
会社は最初の6週間で弁護士の確認時間を70%超削減したと報告しています。ただし初期の自社実績で、あらゆる取引に同じ短縮を保証するものではありません。具体的な調達資金の配分も未公表です。
下書きが何秒で出るかに加えて、専門家がどれだけ早く確認し、責任を持って渡せるか。AIの改善とサービスの価格設計を一緒に考えている点が面白いです。

監査の資料が足りないとき、AIが請求から作業再開まで続けられるでしょうか(prnewswire.com/news-releases…)。Clarkが米国時間11月2日、監査向けAI「Clerks」と1,100万米ドルのシード調達を発表しました。日本時間では11月3日の発表です。
Touring Capitalが主導し、Marathon Management Partners、Rerail、Sofeon Venturesが参加。2025年9月の500万米ドルを含めた累計は1,600万米ドルです。
Clerksは監査案件を担当し、文書確認、テスト、調書作成を進めます。不足資料があれば顧客へ依頼し、返答を追跡。情報が届いたら、改めて指示されなくても作業を再開する仕組みと説明しています。
そのために文書処理、エージェントの実行基盤、複数層の記憶を組み合わせ、案件の文脈を引き継ぎます。監査人の注意が必要な項目は、証拠を添えて引き上げます。
専門的な判断、成果物の確認、監査意見への署名は資格を持つ公認会計士が担当。会社は完全自律の監査業務を将来の目標に掲げていますが、現時点の最終責任までAIへ移した発表ではありません。
資金は製品・開発・営業の人材確保、対応する監査業務の拡大、政府関連監査への展開に使います。文書を生成するだけでなく、返答待ちの間も案件を覚え、情報が増えたところから再開する。専門家の仕事では、こうした継続作業の部分にも価値がありそうです。

自然に話すデモができても、予約や顧客対応の電話を最後まで任せられるでしょうか(aol.com/articles/guava-lands…)。音声エージェント基盤のGuavaが11月3日、1,250万米ドルのシード調達を発表しました。
Acrew Capitalが主導し、Flourish Ventures、WillowTree Ventures、Clocktower Ventures、Commerce Venturesが参加。資金はモデル・製品開発と営業体制の構築に充てます。
Guavaは、音声を文字へ変える認識、内容を判断する言語モデル、声を返す音声合成を、自社で開発・運用する一体の仕組みとして提供します。別々の会社の部品をつなぐ場合に出る遅れや仕様変更も、全体で調整する狙いです。
企業側は、自社のソフトウェアや業務ルールをコードで接続し、エージェントが何を知り、何をしてよいかを定めます。予約受付や問い合わせ対応など、会話の先に実際の処理がある用途です。
会社によると、9月に公開したDaytonaはすでに企業顧客の通話で稼働。一方、端末内処理、自社設備での配置、相手の話を聞きながら話す双方向音声処理は、今回の資金で進める開発対象として説明されています。
声が人間らしいかだけでなく、割り込みや業務条件を扱い、目的の処理まで終えられるか。音声AIの競争が、本番の通話を安定して運用する仕組みにも広がっているのが面白いです。

業務にAIを入れても、データやモデルを自社で管理できるでしょうか(businesswire.com/news/home/2…)。Lazarus AIが11月3日、4,300万米ドルの資金調達を発表しました。
QBE、Mucker Capital、Motivate Ventures、State Farm Venturesなどが参加しています。ラウンド名や詳細条件、主導投資家は発表文では明示されていません。
扱うのは、複雑な文書の理解、ソースコードの脆弱性調査、古いシステムの現代化です。文書では判断の根拠を元ページへ結び付け、コードの脆弱性は再現と証拠を添え、修正を反映する判断は技術者へ残すと説明しています。
旧システムの移行も、コードを生成して終わりにせず、元の処理との同等性を確認する設計です。企業が扱う重要な情報や既存業務を、AIの出力へそのまま置き換えないための仕組みが中心にあります。
基盤は顧客の自社設備やクラウドなどに配置でき、データ、モデル選択、運用費用の管理権を顧客側に残す方針。資金は提携拡大、研究開発、新製品の投入に使います。
AIが何をできるかに加えて、どこで動き、変更を誰が承認し、結果を何で確かめるか。規制の厳しい業務では、その条件まで含めて製品になるのが興味深いです。

弁護士や金融の専門家が持つ「良い仕事の基準」を、AIの学習に使いやすくできるのでしょうか(trajectory.ai/field-notes/in…)。Trajectoryが11月2日、4,500万米ドルのシリーズAと新しい基盤を発表しました。
Sequoiaが主導し、NVIDIA、Bessemer、Bain Capital Venturesが参加。評価額は3億米ドルです。
同社が提供するのは、すでに作られたモデルへ業務データを使って追加学習し、評価して、実際に動かすまでをまとめた基盤。利用者は課題と、その結果をどう採点するかを用意します。
たとえば法律文書なら、もっともらしい文章が出るだけでは足りません。担当者が求める条件や判断基準へ近づけるために、専門家の評価を学習の手がかりにする考え方です。
少数の評価例から採点基準を広げる「Continual Grading」と、本番の対話を学習へ使う「Group Size 1」も紹介しています。ただし、この2機能は研究プレビューで、完成した継続学習機能として扱うものではありません。
専門家が基準を定め、学習や配備に必要な仕組みを基盤側が引き受ける。汎用AIを呼び出す費用だけでなく、自社の判断をモデルへ残せるかが、企業向けAIの選択肢になってきています。

会社の仕事に合わせてAIを育てるなら、学習後の運用まで必要になります(appliedcompute.com/company/1…)。Applied Computeが11月2日、3億5,000万米ドルの調達を発表し、11月3日に取引担当のLatham & Watkinsも確認しました。
評価額は32億5,000万米ドル。Elad Gilが主導し、Kleiner Perkins、Lux Capital、NVIDIA、Blackstoneなどが参加しています。ラウンド名と、評価額が調達前か調達後かは発表されていません。
同社は、重みが公開されたモデルを企業のデータや専門知識で追加学習し、その後の推論、評価、継続改善まで扱います。学習させたモデルを渡して終わりではなく、業務で動かし続ける部分も提供する会社です。
会社の説明では、法律AIのHarvey向けに回答と引用の品質を改善し、比較対象の先端モデルに対する推論費用を半分未満にした例があります。Clay向けには、処理を適したモデルへ振り分ける仕組みを学習し、品質を維持しながら本番の推論費用を最大47%削減したとしています。いずれも会社公表の事例で、すべての企業に同じ改善を保証する数値ではありません。
今回の資金は計算能力、採用、企業への導入拡大へ。汎用モデルをそのまま使う選択肢に加えて、自社の仕事に合わせたAIを保有し、運用しながら直す選択肢が広がっています。モデルを作る技術と、動かし続ける基盤が一体になっている点が面白いです。

生成AIの画像や動画を、本番サービスで大量に動かすには何が必要なのでしょうか(fal.ai/blog/series-e-f)。falが11月3日、シリーズEとFをまとめて発表しました。
画像・動画・音声モデルをAPIで提供し、生成のたびに必要な計算を引き受ける会社です。企業が自社のサービスへ生成AIを組み込むと、モデルの性能だけでなく、待ち時間や同時に処理できる量も問題になります。
今回の発表で、Eは今年すでに完了していたラウンド、Fは新たに発表したラウンドと区別されています。EはSequoia Capital、FはBessemer Venture Partnersが主導し、NVIDIAも継続出資しています。
金額は会社の発表本文にはなく、報道ではF単独が13億米ドル、評価額160億米ドル。Eの約3億5,000万米ドルと合わせて約16億5,000万米ドルです。合計額をFだけの調達額とは扱えません。
資金はモデルを大量に動かす推論能力と、研究・製品を作るチームの拡充へ。falは配信だけでなく、既存モデルを追加学習して改善する領域にも広げています。
生成できるモデルが増えるほど、それを業務の速度と費用で回す基盤が必要になる。制作ツールの裏側で、その運用を引き受ける企業にも投資が向かっているのが興味深いです。

Itaru Tomita / 冨田到 retweeted

ISUCON 参加記を書きました!天然知能で編集しましたが、AI表現が残っていたらごめんなさい。
今回は当日の解法についてです。どんな準備をしたかはまた後日。
ISUCON2026 で優勝しました(当日編) zenn.dev/luvtechno/articles/… #zenn

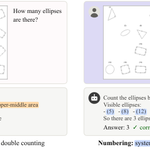
画像の中の物をAIが数え間違えるのは、見えていないからだけでしょうか(arxiv.org/html/2610.39419v1)。「ReGap-Bench」は、何を数えたかを見失う問題に注目しています。
たとえば「左上の楕円」と言葉で追っているうちに、同じ図形をもう一度数えてしまう。図形に番号があれば、「3番、7番、12番」と対象を区別できます。
研究では、図形の数、角度や大きさの順位、時計の時刻順、図形変換の5課題を各200場面用意。元の配置・質問・答えを固定し、番号、薄い塗り、格子だけを変えて比較しています。
結果は「何でも書き足せばよい」ではありませんでした。図形を数える課題では、番号を付けると正解率がモデル平均で11.3ポイント改善。一方、塗りは1.7ポイントの改善にとどまり、格子では4.1ポイント下がっています。
角度の内側を比べるなら塗り、位置や大きさを追うなら格子。必要な作業に合った目印が効きます。Qwen3-VLの20億〜2350億パラメータでも、番号を付ける効果は残りました。
追加学習なしで地図に目印を描くスキルも100課題で試しています。ただし、主な検証は制御された図形問題で、地図の塗りを使う例は3課題だけです。実際の複雑な画像すべてで同じ効果が出るとは言えません。
AIの能力を上げる方法は、モデルの大型化だけではなさそうです。対象を見失わないように、作業に合う参照先を入力画像に作る。資料や画面をAIに読ませるときにも試したくなる工夫です。

動画の前の部分が完成するまで、次の部分は待つしかないのでしょうか(arxiv.org/html/2611.00859v1)。「Wave Forcing」は、生成の途中状態を使って複数の区間を並行して進める研究です。
新しい区間は、それより前の、ノイズが少ない区間を参照します。ノイズ除去の各段階と履歴の更新を、モデルを丸ごと載せた別々のGPUへ分担。パイプラインが埋まった後は、並行計算の1ラウンドごとに1区間を出せる構造です。
1区間あたりの計算を1回に減らしたわけではありません。必要な計算を残したまま、複数区間を重ねて処理します。その進め方に合うよう、学習も段階的に行っています。
Wan2.1-T2V-1.3Bの5ステップ版では、100秒動画のVBench-Long Qualityが81.26で、比較対象のRolling Forcingは81.18。動きの指標に加え、主役が画面から消えないか、カメラが一方向へ流れないかも調べています。
速度は別のシステム計測です。4ステップ版を8枚のH200で動かし、VAEによる映像への復元まで含めて134.8FPS、単一GPU基準の7.07倍と報告。ただし、この速度計測はランダム初期化したダミー重みを使い、モデル読込と動画ファイルへの符号化は除外しています。品質と速度を同時に保証した数値とは分けて読む必要があります。
固定した入力での連続生成が対象で、途中の指示変更や操作への応答速度は未検証です。1つのモデルを速くするだけでなく、生成途中の情報を共有して待ち時間を減らす設計が面白いです。

AIが動画を何度も作り直したら、それは「自己改善」なのでしょうか(arxiv.org/html/2610.40191v1)。「Video Generation Meets Agent Harness」は、この言葉を丁寧に分けているサーベイです。
注目しているのは生成モデルの周りの実行基盤。台本やショットを計画し、参照素材と採用版を管理し、生成結果を見て修正箇所を決め、費用や権限を制御する部分です。
整理の軸は、動画を制作すること、世界モデルの中で行動すること、次のモデル開発を改善すること。きれいな映像を出せるだけでは、物の位置や過去の行動が保たれた世界として使えるとは限りません。
特に大事なのが、「今の動画を直す」「次の制作へ使える手順を残す」「モデルの重みを更新する」「改善を生み出す開発手順そのものを変える」の区別です。
このサーベイの定義では、最後の変更が後の開発を良くしたと独立に検証できて、初めて再帰的な自己改善と呼べます。調査対象のシステムでは、その段階の実証にはまだ至っていないとしています。
また、複数エージェントの効果を見るなら、同じ予算の単独エージェントとも比較する。費用は採用した動画だけでなく、失敗候補や検査も含める。制作を回す人には、この評価の考え方も役立ちそうです。
新しいモデルの性能発表ではなく、制作・対話・開発をどう切り分けて検証するかの見取り図です。動画AIの自動化を考えるとき、「何が次回まで残って良くなったのか」を確認したくなる論文でした。

検索結果がよくクリックされることと、探したかったものが見つかることは同じでしょうか(arxiv.org/html/2610.16927v2)。WeChatの短動画検索向け研究「WeFair」が、このずれを扱っています。
たとえば「ミルクレープ」で食べる動画を探していたのに、過去の視聴履歴から料理好きと判断されて、レシピの検索へ変えられてしまう。履歴には合っていても、いまの目的から外れることがあります。
WeFairは、検索語を補う小さなAIを3段階で学習します。まず検索履歴や実際の言い換えから学び、次に視聴された動画を手がかりに候補を比較。最後は、人が実際に使った言い換え、または「元の検索語を変えない」という正解との一致で調整します。
利用者の行動を全部同じ強さの正解として扱わず、最後の段階では意図の根拠を絞る設計です。検索時には長い思考文を出さず、短い検索語か原文維持を直接返します。
20億パラメータのWeFair-2Bを使った10日間のA/Bテストでは、従来のWeWriteに対してクリック率が相対2.951%増、10秒超の動画視聴率が2.593%増、検索語の再入力率が2.350%減と報告しています。ポイント差ではなく相対変化です。
ただし、これはWeChat内の結果です。論文にも、書き換えで必要な都市名を落としてしまう失敗例があります。クリックや視聴時間を増やすだけでなく、利用者が変えてほしくない条件を守る。検索AIを作るときに考えたい視点です。

ロボットの動きを、何十回も計算し直さずに決められるのでしょうか(arxiv.org/html/2610.35850v1)。「OSWAM」は、動作生成のノイズ除去を1回に減らす研究です。
従来の仕組みでは、ランダムなノイズから少しずつ動作を整えていました。単に計算回数を減らすと、動作の質まで落ちます。
OSWAMは、現在の画像から「どんな動作がありそうか」という手がかりを先に作り、そこを出発点にします。学習時には未来の映像も見られる教師から情報を受け継ぎますが、実行時に未来の動画を生成する必要はありません。
NVIDIA H20で測ったRoboTwin 2.0の50タスクでは、平均成功率90.00%、推論142ms。比較対象のFast-WAMは91.83%、397msでした。成功率は1.83ポイント下がるものの、約2.8倍の高速化です。
別条件のRTX 5090では、言語情報のキャッシュとコンパイル最適化を使い40.81msまで短縮しています。この値はH20の142msとは測定条件が異なります。
実機でもパンをボウルへ入れる、消しゴムを引き出しへ入れる課題を試しています。ただし2タスク各20回の評価なので、広い現場での安定性が示されたわけではありません。
何度も考え直す計算を減らすには、出発点へ必要な情報を持たせる。動作の精度と待ち時間を両方見ながら設計する、参考になる例だと思います。

AIに渡す道具の作り方で、ロボットの賢さはどこまで変わるのでしょうか(arxiv.org/html/2611.01560v1)。オープンモデルを使う「uni-robot-agent」の論文が面白いです。
画像を見る、物の位置を求める、腕を動かす、つかむ。こうした操作と結果の返し方を共通化し、シミュレーターと実機へ接続する仕組みです。
工夫がかなり実務的です。画像・カメラ情報・ロボットの状態を同じ時点で保存して、古い画像と新しい位置情報の食い違いを防ぐ。通信が途切れても同じ命令を重ねて実行しない。腕が動いている間に、次の判断を進めることもできます。
42タスクのRoboDojoでは、Qwen3.8-Flash-Nextが成功率25.00%、部分達成も含むScoreで31.39。同じQwenをRoboProbeへ接続した場合のScoreは1.90でした。シミュレーターの正解の深度や成功判定は使っていませんが、カメラの校正情報などは与えています。
ただし「オープンモデルが最強」という話ではありません。同じuni-robot-agentを使うGPT-6 AstraはScore51.90。精密な操作や長い手順には課題が残ります。実機19タスクの比較も、提案手法だけが深度情報を受け取るため条件差があります。
モデルを大きくするだけでなく、観察と実行を取り違えず、失敗から戻れる接続部分を整える。小さなチームがロボットAIを試すうえでも、参考になる設計かもしれません。

AI生成画像だけでなく、偽造文書や動画、マスクなどによる物理的な偽装まで、まとめて判別するVenus-DefakerOne2が公開された(arxiv.org/html/2610.37918v2)。
基盤はQwen3.5-2B。デジタルな加工か物理的な偽装か、静止画か動画かという違いをまたいで、本物と偽物を判定する。少量の追加パラメータを学ぶLoRAと、モデル本体の調整を交互に使い、幅広い事例と難しい事例を学習する。
動画では、時間方向の不自然さが手掛かりになる場合も、1枚の細部が重要な場合もある。そこで動画として見る結果と、フレーム列として見る結果の不確かさを比較し、使う形式を選ぶ。
現実的なうわさ動画を想定したRRVBenchでは、11種類の生成モデルで作った動画を評価し、平均のバランス精度は95.3%。これは本物と偽物のそれぞれを正しく判別する割合を平均した指標で、実際のSNSでの検出率や誤検知率そのものではない。
著者も、人には明らかな異常を見落とす場合があると明記している。加工箇所を示すマスクも、本物かどうかの判定と食い違うことがあり、偽造の確定証拠として扱うものではない。
検出対象を広げる方向は実用的。ただ、出力が「偽物」だったという理由だけで断定せず、原典や別の証拠と突き合わせる使い方が必要になりそう。

個人で言語モデルを作ったMetis-1.6の報告は、性能だけでなく「何がうまく動かなかったか」まで公開しているのが面白い(arxiv.org/html/2610.37903v1)。
構造はMoE(入力ごとに一部の専門ネットワークを選ぶ方式)と、系列を効率よく処理するMamba-2、注意機構を組み合わせたもの。同じ層をトークンごとに2回通し、重みを増やさず計算の深さを増やす。
大きい方のLogosは総パラメータ10.23B、1回の通過で稼働するのは1.18B。ただし2回通すので、トークン当たりの稼働量は2.36Bとして数える。各モデルの学習量は合計1.02兆トークンだった。
著者の比較環境では、Logosの40ベンチマーク平均は52.93点で17モデル中7位。数学に強い一方、コード、指示への追従、長文処理などには弱さが残る。
失敗例も具体的。追加した単語列の記憶部品は、学習中にモデル自身が接続をほぼ閉じて使わなくなった。さらに、設定した最適化手法が実際には使われず、注意機構は別の手法で学習されていた。
数学問題の一部は学習データとの重複検査が未完了で、構造そのものの効果も学習設定と切り分けられていない。単純な性能順位より、実行された設定と部品の寄与を確かめる記録として参考になる。

Claudeを開発するAnthropicが、予定する米国IPOの一環として、日本で最大35億米ドルの資金調達を計画しているとTBSが報じた(news.livedoor.com/article/de…)。11月2日に提出した届出に関する報道で、資金調達が完了したという発表ではない。
35億米ドルは日本向け募集の上限。IPO全体の調達額や、企業の評価額を示す数字ではない。実際の売出価格と株数は、需要などを見て今後決まる。
Reutersも同じ届出を報道し、日本の投資家向けに新たに発行する株式の資金は、運転資金、営業費用、設備投資へ充てる計画としている。国内の取りまとめ役はみずほ証券で、出資を決めた投資家という意味ではない。
AI企業への資金供給が、日本の公開市場の投資家にも広がる計画として注目したい。ただ、募集枠が示された段階と、価格が決まって実際に資金が入った段階は分けて見る必要がある。
